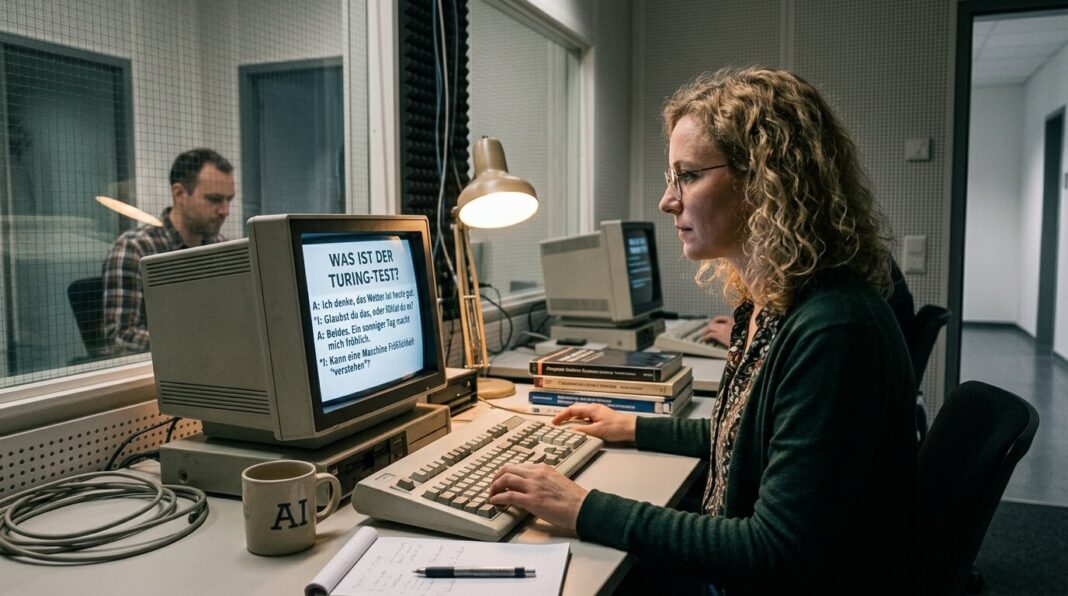

Stell dir vor, du führst einen Chat mit zwei unbekannten Gesprächspartnern. Beide beantworten deine Fragen, argumentieren überzeugend, erzählen Geschichten und reagieren auf deine Aussagen. Einer der beiden ist ein Mensch, der andere eine künstliche Intelligenz. Du weißt allerdings nicht, wer wer ist. Kannst du zuverlässig erkennen, mit wem du sprichst? Oder ist die Maschine inzwischen so gut geworden, dass du keinen Unterschied mehr bemerkst?
Genau an dieser Stelle beginnt eine der spannendsten Fragen der Informatik: Kann eine Maschine menschliche Intelligenz so überzeugend nachahmen, dass wir sie nicht mehr von einem Menschen unterscheiden können? Bereits 1950 beschäftigte sich der britische Mathematiker und Computerpionier Alan Turing mit dieser Herausforderung. Seine Überlegungen legten einen wichtigen Grundstein für die spätere Entwicklung der künstlichen Intelligenz und beeinflussen bis heute die Diskussion darüber, was intelligente Maschinen eigentlich leisten können.
Der sogenannte Turing-Test ist dabei weit mehr als ein historisches Gedankenexperiment. In einer Welt, in der KI-Systeme Texte schreiben, programmieren, komplexe Fragen beantworten und natürliche Gespräche führen, gewinnt seine ursprüngliche Idee eine neue Bedeutung. Gleichzeitig müssen wir genauer hinsehen: Eine Maschine, die intelligent klingt, muss nicht zwangsläufig intelligent sein. Und selbst wenn sie sich in einem Gespräch wie ein Mensch verhält, ist damit noch lange nicht geklärt, ob sie tatsächlich versteht, was sie sagt.
Dieser Artikel erklärt verständlich und fachlich fundiert, was der Turing-Test ist, wie er funktioniert, welche Rolle er für die Entwicklung künstlicher Intelligenz spielt und wo seine Grenzen liegen. Außerdem erfährst du, was moderne KI-Systeme wie große Sprachmodelle mit Turings Idee zu tun haben und warum die entscheidende Frage heute möglicherweise nicht mehr lautet, ob eine Maschine menschlich wirken kann.
Was ist der Turing-Test? Definition und Bedeutung
Der Turing-Test ist ein von Alan Turing vorgeschlagenes Verfahren, mit dem untersucht werden soll, ob eine Maschine in einer Unterhaltung ein menschenähnliches Verhalten zeigen kann. Die grundlegende Idee besteht darin, einen menschlichen Gesprächspartner anhand seiner Antworten beurteilen zu lassen, ob er mit einem Menschen oder einer Maschine kommuniziert. Dabei soll nicht das technische Innenleben des Computers untersucht werden. Entscheidend ist vielmehr, wie sich das System im direkten Vergleich mit einem Menschen verhält.
Turing veröffentlichte seine Überlegungen 1950 in dem wissenschaftlichen Aufsatz „Computing Machinery and Intelligence“. Darin stellte er die damals provokante Frage, ob Maschinen denken können. Statt sich in einer Diskussion über die genaue Definition des Denkens zu verlieren, schlug er ein konkreteres Verfahren vor: das sogenannte Imitation Game, auf Deutsch Imitationsspiel. Dieses Spiel wurde zur Grundlage dessen, was heute allgemein als Turing-Test bezeichnet wird.
Die Bedeutung dieses Ansatzes liegt vor allem in seinem Perspektivwechsel. Anstatt zunächst festzulegen, was Denken philosophisch oder biologisch genau bedeutet, konzentriert sich der Test auf beobachtbares Verhalten. Eine Maschine soll zeigen, ob sie in einer anspruchsvollen Unterhaltung mit einem Menschen mithalten kann. Das ist ein pragmatischer Ansatz, der sich grundsätzlich überprüfen lässt. Allerdings beantwortet er damit nur eine bestimmte Frage: Wie überzeugend kann eine Maschine menschliche Gesprächsfähigkeiten nachahmen?
Wichtig ist deshalb die Abgrenzung: Der Turing-Test ist kein allgemeingültiger Nachweis dafür, dass eine Maschine Bewusstsein besitzt, Gefühle erlebt oder die Welt so versteht wie ein Mensch. Er untersucht eine bestimmte Form intelligent erscheinenden Verhaltens. Genau diese Unterscheidung ist entscheidend, wenn wir die Fähigkeiten moderner KI-Systeme realistisch einschätzen wollen.
Wer war Alan Turing und warum entwickelte er den Test?
Alan Turing war ein britischer Mathematiker, Logiker und Computerwissenschaftler, der zu den wichtigsten Wegbereitern der modernen Informatik zählt. Seine theoretischen Arbeiten über berechenbare Funktionen und abstrakte Rechenmaschinen beeinflussten maßgeblich das Verständnis dessen, was Computer grundsätzlich berechnen können. Während des Zweiten Weltkriegs arbeitete er außerdem an der Entzifferung deutscher verschlüsselter Nachrichten. Seine Beiträge zur Kryptanalyse gehören zu den bedeutenden Kapiteln der Geschichte der Informatik.
Nach dem Krieg beschäftigte sich Turing zunehmend mit der Frage, welche Aufgaben Maschinen übernehmen könnten und ob sich menschliche geistige Fähigkeiten zumindest teilweise durch Computer nachbilden lassen. Die Entwicklung elektronischer Rechner eröffnete damals völlig neue Möglichkeiten. Dennoch waren Computer jener Zeit weit von den vielseitigen Systemen entfernt, die wir heute kennen. Turings Überlegungen waren deshalb bemerkenswert vorausschauend: Er dachte nicht nur über Rechenleistung nach, sondern auch über Sprache, Lernen und intelligentes Verhalten.
Mit seinem Aufsatz „Computing Machinery and Intelligence“ wollte Turing die Diskussion über maschinelles Denken auf eine konkretere Grundlage stellen. Die Frage „Können Maschinen denken?“ erschien ihm zu unbestimmt, um darüber sinnvoll und eindeutig zu diskutieren. Menschen verstehen unter Denken schließlich unterschiedliche Dinge. Manche meinen logisches Schlussfolgern, andere Kreativität, Selbstbewusstsein, Sprachverständnis oder die Fähigkeit, aus Erfahrungen zu lernen.
Sein Vorschlag war deshalb, eine beobachtbare Leistung als Ausgangspunkt zu nehmen. Wenn eine Maschine in einer Unterhaltung so überzeugend antwortet, dass ein menschlicher Prüfer sie nicht zuverlässig von einem Menschen unterscheiden kann, liefert das zumindest einen konkreten Hinweis auf ihre sprachlichen und verhaltensbezogenen Fähigkeiten. Damit verschob Turing die Debatte von einer abstrakten Definition hin zu einer überprüfbaren Herausforderung.
Seine Idee ist bis heute relevant, weil sie eine zentrale Frage der künstlichen Intelligenz berührt: Wie können wir beurteilen, ob ein technisches System tatsächlich leistungsfähig ist, ohne uns ausschließlich auf seine technische Konstruktion oder seine Selbstaussagen zu verlassen? Allerdings darf man Turings ursprünglichen Vorschlag nicht mit jeder späteren Variante des Turing-Tests gleichsetzen. Im Laufe der Jahrzehnte wurden unterschiedliche Testverfahren entwickelt, die sich teilweise deutlich voneinander unterscheiden.
Wie funktioniert der Turing-Test in der Praxis?
Das Grundprinzip des Turing-Tests lässt sich anhand einer einfachen Unterhaltung erklären. Ein menschlicher Prüfer kommuniziert mit zwei unbekannten Gesprächspartnern, die beispielsweise mit X und Y bezeichnet werden. Einer davon ist ein Mensch, der andere eine Maschine. Der Prüfer darf Fragen stellen und die Antworten miteinander vergleichen. Seine Aufgabe besteht darin, herauszufinden, welcher Gesprächspartner der Mensch und welcher der Computer ist.
Die Kommunikation erfolgt in der klassischen Vorstellung über einen textbasierten Kanal. Dadurch werden äußerliche Merkmale wie Stimme, Aussehen oder Körpersprache ausgeblendet. Der Prüfer soll seine Entscheidung auf Grundlage der Antworten treffen. Das System muss deshalb nicht nur einzelne Fragen korrekt beantworten, sondern sich möglichst überzeugend an einer Unterhaltung beteiligen. Turings ursprünglicher Vorschlag war allerdings ein Imitationsspiel mit einer besonderen Struktur; viele heute als Turing-Test bezeichnete Verfahren sind vereinfachte oder weiterentwickelte Varianten davon.
Damit das Verfahren sinnvoll funktioniert, müssen die Rahmenbedingungen festgelegt werden. Dazu gehören die Dauer der Unterhaltung, die Art der zulässigen Fragen, die Anzahl der Prüfer und die Kriterien, nach denen ihre Entscheidungen ausgewertet werden. Ohne solche Regeln lässt sich kaum beurteilen, ob ein Ergebnis tatsächlich aussagekräftig ist. Ein kurzer Austausch über ein einfaches Thema stellt schließlich andere Anforderungen als ein längeres Gespräch mit Rückfragen, Widersprüchen und komplexen Zusammenhängen.
Ein Beispiel verdeutlicht das Prinzip. Der Prüfer fragt beide Gesprächspartner, wie sie mit einem misslungenen Projekt umgehen würden. Der Mensch beschreibt vielleicht seine Erfahrungen, erklärt einen Fehler und reflektiert, was er daraus gelernt hat. Die KI formuliert ebenfalls eine plausible Antwort und nennt mehrere Maßnahmen zur Verbesserung. Anschließend fragt der Prüfer nach einem konkreten Detail, widerspricht einem Argument oder wechselt das Thema. Nun zeigt sich, ob die Antworten auch unter veränderten Bedingungen überzeugend bleiben.
Der entscheidende Punkt ist nicht, ob eine KI eine einzelne Frage richtig beantwortet. Entscheidend ist vielmehr, wie gut sie über einen bestimmten Zeitraum hinweg eine menschenähnliche Unterhaltung aufrechterhalten kann. Ein leistungsfähiges System muss dafür unter anderem Sprache verarbeiten, Zusammenhänge berücksichtigen, passende Antworten erzeugen und auf den Gesprächsverlauf reagieren. Ob diese Fähigkeiten bereits als echtes Denken gelten, ist eine andere Frage.
Welche Fähigkeiten muss eine KI für den Turing-Test beherrschen?
Eine KI, die in einem Turing-Test überzeugend abschneiden soll, benötigt mehr als einen großen Vorrat an Fakten. Sie muss sprachliche Informationen verarbeiten, die Bedeutung einer Frage im jeweiligen Kontext berücksichtigen und eine passende Antwort formulieren. Außerdem sollte sie auf Rückfragen reagieren können, statt lediglich vorbereitete Textbausteine auszugeben. Je anspruchsvoller das Gespräch gestaltet ist, desto schwieriger wird es, durch oberflächliche Sprachmuster überzeugend zu wirken.
Dabei spielen mehrere Fähigkeiten zusammen. Die Sprachverarbeitung bildet die Grundlage, weil das System Fragen verstehen und Antworten in natürlicher Sprache erzeugen muss. Kontextverarbeitung ist ebenfalls wichtig, damit frühere Aussagen im weiteren Gespräch berücksichtigt werden können. Darüber hinaus helfen Schlussfolgerungsfähigkeiten, komplexe Fragen zu bearbeiten und widersprüchliche Informationen zu erkennen. Je nach Aufgabenstellung können auch Allgemeinwissen, Humor, Perspektivwechsel und die Fähigkeit zum Umgang mit Unsicherheit eine Rolle spielen.
Ein weiterer wichtiger Faktor ist die Gesprächskonsistenz. Menschen erwarten, dass ihr Gegenüber nicht bei jeder Rückfrage seine grundlegende Position ändert oder bereits genannte Informationen beliebig vergisst. Eine KI muss deshalb innerhalb des verfügbaren Gesprächskontexts möglichst nachvollziehbar antworten. Das bedeutet allerdings nicht, dass sie sich niemals irren darf. Auch Menschen machen Fehler, missverstehen Fragen oder vertreten widersprüchliche Ansichten. Ein künstliches System kann daher gerade dann menschlich wirken, wenn es typische menschliche Kommunikationsmuster zeigt.
Gleichzeitig entstehen dadurch neue Herausforderungen für die Bewertung. Ein System könnte absichtlich knapp antworten, bestimmte Fragen ausweichen oder menschliche Fehler nachahmen, um glaubwürdiger zu wirken. Ein anderes könnte besonders sachlich, höflich und strukturiert kommunizieren und deshalb von einem Prüfer als Maschine erkannt werden, obwohl es inhaltlich leistungsfähig ist. Das Ergebnis hängt somit nicht nur von der KI ab, sondern auch von den Erwartungen, Erfahrungen und Bewertungsmaßstäben des Menschen.
Für die Praxis bedeutet das: Ein überzeugender Turing-Test erfordert eine sorgfältige Gestaltung der Fragen und der Auswertung. Die bloße Fähigkeit, grammatikalisch korrekte Sätze zu produzieren, reicht nicht aus. Interessant wird es erst, wenn ein System über unterschiedliche Themen hinweg nachvollziehbar argumentiert, auf neue Informationen reagiert und seine Antworten an die konkrete Gesprächssituation anpasst.
Hat eine KI den Turing-Test bereits bestanden?
Die Frage, ob eine KI den Turing-Test bestanden hat, klingt nach einer einfachen Ja-oder-Nein-Entscheidung. Tatsächlich ist die Antwort komplizierter, weil es keine einzige, allgemein verbindliche Testvariante mit universell akzeptierten Bestehenskriterien gibt. Unterschiedliche Experimente verwenden verschiedene Gesprächsdauern, Fragestellungen, Vergleichspersonen und Bewertungsmethoden. Deshalb lassen sich Ergebnisse nicht ohne Weiteres miteinander vergleichen.
Im Laufe der Geschichte gab es zahlreiche Versuche, Maschinen in Gesprächen möglichst menschlich erscheinen zu lassen. Frühe Programme konnten beispielsweise einfache Dialoge führen, indem sie bestimmte Wörter erkannten und darauf mit vorgegebenen Mustern reagierten. Solche Systeme konnten in kurzen Gesprächen durchaus überraschend wirken. Sobald die Unterhaltung jedoch über ihren begrenzten Themenbereich hinausging, wurden ihre Einschränkungen häufig deutlich.
Mit der Entwicklung moderner Sprachmodelle hat sich die Situation erheblich verändert. Große Sprachmodelle, sogenannte Large Language Models oder LLMs, können umfangreiche Texte erzeugen, Fragen beantworten, unterschiedliche Schreibstile imitieren und auf komplexe Gesprächsverläufe reagieren. Dadurch sind sie in vielen sprachlichen Situationen deutlich leistungsfähiger als frühere Dialogprogramme. Die Frage, ob sie einen bestimmten Turing-Test bestehen könnten, hängt jedoch weiterhin von der jeweiligen Versuchsanordnung ab.
Ein häufiges Missverständnis besteht darin, einzelne erfolgreiche Gespräche bereits als endgültigen Beweis zu betrachten. Wenn eine Person in einem kurzen Chat nicht erkennt, dass sie mit einer KI kommuniziert, sagt das zunächst etwas über diese Unterhaltung und die betreffende Person aus. Daraus folgt nicht automatisch, dass die Maschine in jeder Gesprächssituation menschlich wirken würde. Ebenso wenig beweist ein einzelner Fehler, dass ein System grundsätzlich nicht zu anspruchsvollen sprachlichen Leistungen fähig ist.
Die fachlich saubere Antwort lautet daher: Es gibt keinen universell anerkannten, endgültigen Nachweis, mit dem sich pauschal feststellen ließe, dass eine bestimmte KI den Turing-Test unter allen relevanten Bedingungen bestanden hat. Aussagen über ein Bestehen müssen immer benennen, welcher Test verwendet wurde, wie viele Personen beteiligt waren, welche Bedingungen galten und wie die Ergebnisse gemessen wurden.
Turing-Test und moderne KI: Was hat sich verändert?
Moderne KI-Systeme haben die ursprüngliche Fragestellung in den Alltag gebracht. Während Turing seine Überlegungen zu einer Zeit formulierte, in der elektronische Computer noch vergleichsweise eingeschränkt waren, können heutige Sprachmodelle innerhalb von Sekunden umfangreiche Texte verfassen, Programmiervorschläge entwickeln oder komplizierte Sachverhalte erklären. Sie lassen sich in Kundenservice, Softwareentwicklung, Wissensmanagement und zahlreichen weiteren Anwendungsfeldern einsetzen. Dadurch erleben Menschen zunehmend Situationen, in denen maschinell erzeugte Antworten auf den ersten Blick kaum von menschlichen Texten zu unterscheiden sind.
Ein wesentlicher Unterschied liegt in der technischen Grundlage. Moderne Sprachmodelle werden anhand großer Datenmengen trainiert und lernen dabei statistische Zusammenhänge zwischen Sprachelementen. Auf dieser Basis erzeugen sie Antworten, die zum jeweiligen Kontext passen sollen. Sie können Informationen kombinieren, Formulierungen variieren und komplexe sprachliche Strukturen verarbeiten. Das ermöglicht beeindruckende Ergebnisse, bedeutet aber nicht automatisch, dass sie jedes Thema zuverlässig verstehen oder jede Aussage auf ihren Wahrheitsgehalt überprüfen können.
Ein praktisches Beispiel ist der Kundenservice. Eine KI kann eine Beschwerde analysieren, die wichtigsten Anliegen zusammenfassen und eine höfliche Antwort formulieren. Sie kann möglicherweise sogar verschiedene Lösungsmöglichkeiten abwägen und gezielte Rückfragen stellen. Für den Kunden kann das Gespräch dadurch ähnlich wirken wie der Kontakt mit einem erfahrenen Servicemitarbeiter. Trotzdem muss geprüft werden, ob die vorgeschlagene Lösung tatsächlich zulässig ist, die Unternehmensregeln berücksichtigt und zum konkreten Kundenfall passt.
Ähnliches gilt für die Softwareentwicklung. Eine KI kann Code erklären, Fehlerquellen benennen und Vorschläge für eine technische Umsetzung liefern. In einem Gespräch kann sie dabei den Eindruck eines fachkundigen Entwicklers erwecken. Doch sprachliche Sicherheit und technische Korrektheit sind zwei unterschiedliche Dinge. Ein Vorschlag kann überzeugend formuliert sein und dennoch einen Sicherheitsfehler, eine falsche Annahme oder eine unpassende Architekturentscheidung enthalten.
Der Turing-Test hilft uns, die Entwicklung dieser Systeme historisch einzuordnen. Er liefert aber keine vollständige Bewertung ihrer praktischen Qualität. Für Unternehmen ist deshalb entscheidend, nicht nur die sprachliche Überzeugungskraft zu betrachten, sondern auch die tatsächliche Leistung, Zuverlässigkeit und Kontrollierbarkeit. Eine KI muss nicht menschlich wirken, um einen hohen wirtschaftlichen Nutzen zu haben. Umgekehrt ist eine KI, die sich überzeugend ausdrückt, nicht automatisch für jede Aufgabe geeignet.
Wo liegen die Grenzen des Turing-Tests?
Der Turing-Test ist ein einflussreicher Ansatz, aber kein vollständiges Messinstrument für Intelligenz. Seine größte Stärke besteht darin, eine konkrete Form menschlich wirkenden Verhaltens untersuchbar zu machen. Seine größte Schwäche liegt darin, dass die Ergebnisse leicht überinterpretiert werden können. Wer aus einem überzeugenden Gespräch unmittelbar auf Bewusstsein, echtes Verständnis oder allgemeine Intelligenz schließt, geht über das hinaus, was der Test tatsächlich nachweisen kann.
Eine grundlegende Herausforderung ist die Unterscheidung zwischen sprachlicher Leistung und Verständnis. Eine KI kann eine Frage korrekt beantworten, ohne dass damit geklärt wäre, auf welche Weise sie die Bedeutung der Frage verarbeitet. Menschen können ebenfalls Informationen wiedergeben, ohne sie tiefgehend verstanden zu haben. Bei Maschinen ist die Frage jedoch besonders umstritten, weil wir nicht ohne Weiteres dieselben inneren Erfahrungen voraussetzen können, die wir bei Menschen vermuten.
Hinzu kommt die Abhängigkeit vom Prüfer. Menschen beurteilen Gespräche anhand ihrer eigenen Erwartungen, ihrer Fachkenntnisse und ihrer Vorstellungen davon, wie sich ein Mensch normalerweise ausdrückt. Manche erkennen technische Formulierungen schnell als Hinweis auf eine KI. Andere halten eine höfliche, sachliche und gut strukturierte Antwort für ein Zeichen menschlicher Kompetenz. Ein Testergebnis kann deshalb durch die Gestaltung des Experiments und die Eigenschaften der beteiligten Personen beeinflusst werden.
Auch der Umfang des Tests ist entscheidend. Ein kurzer Chat mit allgemeinen Fragen stellt nur begrenzte Anforderungen. Ein längeres Gespräch, das konkrete Erfahrungen, fachliche Details, Widersprüche und wechselnde Aufgaben einbezieht, kann deutlich anspruchsvoller sein. Doch selbst ein umfangreicher Test bleibt auf die untersuchten Fähigkeiten beschränkt. Er zeigt nicht automatisch, ob eine KI in der realen Welt eigenständig handeln, aus Fehlern lernen oder unter völlig neuen Bedingungen zuverlässig arbeiten kann.
Schließlich besteht die Gefahr, menschliches Verhalten zum alleinigen Maßstab für Intelligenz zu machen. Eine Maschine könnte Aufgaben hervorragend lösen, ohne dabei wie ein Mensch zu kommunizieren. Ein intelligentes System muss nicht zwangsläufig menschliche Schwächen, Vorlieben oder Denkgewohnheiten imitieren. Wenn wir Intelligenz ausschließlich daran messen, wie ähnlich sich eine Maschine und ein Mensch in einem Gespräch verhalten, übersehen wir möglicherweise andere Formen leistungsfähiger Problemlösung.
Das Chinesische-Zimmer-Argument: Kann eine Maschine sprechen, ohne zu verstehen?
Eine der bekanntesten philosophischen Kritiken am Turing-Test stammt vom amerikanischen Philosophen John Searle. Er veröffentlichte 1980 sein Gedankenexperiment zum sogenannten Chinesischen Zimmer, international bekannt als Chinese Room Argument. Damit wollte er zeigen, dass ein System überzeugende sprachliche Antworten erzeugen kann, ohne dass daraus zwingend echtes Verständnis folgt. Das Argument gehört bis heute zu den einflussreichen Debatten über künstliche Intelligenz, Sprache und Bewusstsein.
Stell dir vor, eine Person sitzt in einem abgeschlossenen Raum. Sie versteht kein Chinesisch, verfügt aber über ein umfangreiches Regelbuch, das ihr erklärt, wie sie auf bestimmte chinesische Schriftzeichen reagieren soll. Von außen werden Fragen in chinesischer Schrift in den Raum gegeben. Die Person folgt den Regeln, kombiniert die Zeichen und gibt passende Antworten zurück. Für Menschen außerhalb des Raumes kann es so aussehen, als würde jemand im Inneren Chinesisch verstehen. Tatsächlich weiß die Person selbst jedoch nicht, was die Zeichen bedeuten.
Searle überträgt dieses Gedankenexperiment auf Computerprogramme. Ein Programm kann Symbole nach festgelegten Regeln verarbeiten und Antworten erzeugen, die für einen Beobachter sinnvoll erscheinen. Daraus folgt nach seiner Argumentation nicht automatisch, dass das System die Bedeutung dieser Symbole tatsächlich versteht. Er unterscheidet damit zwischen Syntax, also der formalen Verarbeitung von Zeichen, und Semantik, also ihrer Bedeutung. Seine Kritik richtet sich insbesondere gegen die Vorstellung, dass die Ausführung eines geeigneten Programms allein bereits echtes Verständnis hervorbringt.
Das Argument ist allerdings umstritten. Kritiker wenden beispielsweise ein, dass nicht die einzelne Person im Raum, sondern das gesamte System aus Regeln, Speicher und Verarbeitung als relevante Einheit betrachtet werden müsse. Andere halten die Annahme für problematisch, dass sich Verständnis allein anhand einer intuitiven Vorstellung darüber beurteilen lässt, was im Inneren des Systems vor sich geht. Die Debatte ist deshalb nicht abschließend entschieden.
Für moderne Sprachmodelle ist diese Diskussion besonders interessant. Ihre Antworten können sinnvoll, differenziert und fachlich anspruchsvoll erscheinen. Trotzdem bleibt die Frage, wie sich ihre sprachlichen Fähigkeiten zu menschlichem Verständnis verhalten. Der Turing-Test liefert dazu einen beobachtbaren Vergleich, aber keine abschließende philosophische Antwort. Er zeigt, was ein System im Gespräch leisten kann, während das Chinesische-Zimmer-Argument daran erinnert, dass beobachtbare Leistung und die Frage nach Verständnis nicht einfach gleichgesetzt werden sollten.
Warum der Turing-Test für Unternehmen und den digitalen Alltag wichtig ist
Die Bedeutung des Turing-Tests reicht weit über die theoretische Informatik hinaus. Unternehmen setzen KI zunehmend in Bereichen ein, in denen Kommunikation, Wissensverarbeitung und Entscheidungsunterstützung eine Rolle spielen. Wenn eine Maschine überzeugend mit Kunden, Beschäftigten oder Geschäftspartnern kommunizieren kann, eröffnen sich neue Möglichkeiten für Automatisierung und Produktivität. Gleichzeitig entstehen neue Anforderungen an Qualitätssicherung, Transparenz und Verantwortung.
Ein gutes Beispiel ist der Kundenservice. KI-Systeme können Standardanfragen beantworten, Informationen aus Wissensdatenbanken zusammenstellen und Mitarbeitende bei der Bearbeitung komplexer Fälle unterstützen. Das kann Wartezeiten verkürzen und Beschäftigte entlasten. Voraussetzung ist allerdings, dass die Systeme auf verlässliche Informationen zugreifen, ihre Grenzen erkennen und problematische Fälle an Menschen weiterleiten können. Ein freundlicher Ton ersetzt schließlich keine korrekte Auskunft.
Auch im Wissensmanagement können KI-Systeme einen erheblichen Nutzen bieten. Sie können interne Dokumente zusammenfassen, Informationen auffindbar machen und komplexe Inhalte verständlicher aufbereiten. Beschäftigte müssen dadurch möglicherweise weniger Zeit mit der manuellen Suche nach Informationen verbringen. Allerdings hängt der tatsächliche Nutzen von der Qualität der Daten, den Zugriffsrechten und der technischen Integration ab. Eine überzeugend formulierte Antwort ist wenig hilfreich, wenn sie auf veralteten Dokumenten oder unzulässigen Datenzugriffen beruht.
Für Unternehmen ist daher eine Unterscheidung besonders wichtig: Der Turing-Test untersucht, wie menschenähnlich eine Maschine kommunizieren kann. Eine betriebliche KI-Bewertung muss zusätzlich prüfen, ob das System die vorgesehene Aufgabe korrekt, sicher und wirtschaftlich sinnvoll erfüllt. Dafür braucht es konkrete Qualitätskriterien, geeignete Testdaten, nachvollziehbare Ergebnisse und klare Verantwortlichkeiten. Je größer die Auswirkungen einer falschen Antwort sind, desto sorgfältiger müssen die Kontrollen ausfallen.
Wer KI sinnvoll einsetzen möchte, sollte deshalb nicht versuchen, jede Maschine möglichst menschlich erscheinen zu lassen. Viel wichtiger ist es, das System für einen klar definierten Zweck auszuwählen und seine Leistung anhand realer Anforderungen zu überprüfen. Ein KI-Assistent muss beispielsweise nicht wie ein erfahrener Jurist klingen, wenn er lediglich dabei helfen soll, interne Dokumente zu durchsuchen. Er muss die relevanten Informationen zuverlässig finden und kenntlich machen, wenn die vorhandene Datenbasis keine sichere Antwort ermöglicht.
Die entscheidende unternehmerische Frage lautet deshalb nicht nur: Kann die KI einen Menschen imitieren? Sondern vor allem: Kann sie die Aufgabe zuverlässig lösen, für die wir sie einsetzen wollen?
Welche Alternativen und Ergänzungen zum Turing-Test gibt es?
Weil der Turing-Test nur einen bestimmten Ausschnitt intelligenter Fähigkeiten untersucht, werden in der KI-Forschung weitere Bewertungsverfahren verwendet. Diese konzentrieren sich auf konkrete Aufgaben, messbare Ergebnisse oder definierte Fähigkeiten. Je nach Einsatzgebiet kann das aussagekräftiger sein als ein allgemeines Gespräch mit einem menschlichen Prüfer. Ein Sprachmodell, das in einem Chat überzeugend wirkt, muss schließlich nicht automatisch mathematische Probleme zuverlässig lösen oder Software sicher entwickeln können.
Zu den wichtigen Ergänzungen gehören standardisierte Benchmarks. Dabei bearbeiten KI-Systeme festgelegte Aufgaben, deren Ergebnisse anhand vorher definierter Kriterien bewertet werden. Solche Tests können beispielsweise Sprachverständnis, mathematische Fähigkeiten, Programmierung oder logisches Schlussfolgern untersuchen. Ihre Aussagekraft hängt allerdings von der Qualität der Aufgaben und der Bewertungsmethode ab. Außerdem besteht das Risiko, dass ein Modell bei bestimmten Tests gut abschneidet, weil ähnliche Aufgaben in seinen Trainingsdaten vorkamen.
Eine weitere Möglichkeit sind praxisnahe Tests. Dabei wird eine KI in einer kontrollierten Umgebung mit Aufgaben konfrontiert, die ihren späteren Einsatz realistisch abbilden. Im Kundenservice könnte beispielsweise untersucht werden, wie zuverlässig sie Anfragen klassifiziert, korrekte Informationen liefert und schwierige Fälle erkennt. In der Softwareentwicklung ließen sich dagegen die Funktionalität des erzeugten Codes, seine Sicherheit und seine Wartbarkeit bewerten. Solche Verfahren helfen dabei, die tatsächliche Eignung eines Systems für einen bestimmten Zweck zu beurteilen.
Auch Robustheit und Sicherheit müssen berücksichtigt werden. Ein KI-System sollte nicht nur bei einfachen Standardfragen funktionieren, sondern auch mit unklaren Eingaben, widersprüchlichen Informationen und ungewöhnlichen Situationen umgehen können. Dabei ist wichtig, ob es Unsicherheit angemessen kommuniziert und bei Bedarf eine menschliche Prüfung ermöglicht. Gerade bei sensiblen Entscheidungen kann diese Fähigkeit wichtiger sein als ein möglichst menschlicher Gesprächsstil.
Schließlich sollten Bewertungen wiederholbar und transparent sein. Ein einzelnes beeindruckendes Ergebnis reicht nicht aus, um die langfristige Leistungsfähigkeit eines Systems zu belegen. Sinnvoll sind mehrere Testdurchläufe, unterschiedliche Aufgabentypen und eine Dokumentation der jeweiligen Bedingungen. So lässt sich besser erkennen, wo ein System zuverlässig arbeitet, welche Fehler regelmäßig auftreten und welche Grenzen bei seiner Verwendung berücksichtigt werden müssen.
Ist der Turing-Test heute noch zeitgemäß?
Ja, der Turing-Test ist weiterhin relevant, aber seine Rolle hat sich verändert. Als historischer und philosophischer Ausgangspunkt hilft er uns, über maschinelle Intelligenz, Sprache und menschliche Wahrnehmung nachzudenken. Gleichzeitig zeigt die Entwicklung moderner KI, dass menschenähnliche Kommunikation längst keine rein theoretische Möglichkeit mehr ist. Systeme können in vielen Situationen Antworten formulieren, die auf den ersten Blick von menschlichen Beiträgen kaum zu unterscheiden sind.
Gerade deshalb ist es wichtig, den Test nicht als abschließendes Urteil über künstliche Intelligenz zu betrachten. Die Fähigkeit, menschlich zu wirken, ist nur eine von vielen Eigenschaften, die für die Bewertung eines KI-Systems relevant sein können. Je nach Einsatzgebiet zählen andere Faktoren stärker: fachliche Korrektheit, Zuverlässigkeit, Sicherheit, Nachvollziehbarkeit oder die Fähigkeit, sich in bestehende Arbeitsabläufe einzufügen. Ein System kann in einem Gespräch überzeugend sein und dennoch bei einer konkreten Aufgabe versagen.
Darüber hinaus sollten wir vermeiden, menschliches Verhalten automatisch mit überlegenem Verhalten gleichzusetzen. Maschinen können Informationen schneller verarbeiten, große Datenmengen analysieren oder bestimmte Berechnungen zuverlässiger durchführen als Menschen. Dafür fehlen ihnen möglicherweise andere Fähigkeiten, die in einer konkreten Situation wichtig sind. Ein sinnvoller Vergleich muss daher berücksichtigen, welche Aufgabe erfüllt werden soll und welche Eigenschaften dafür tatsächlich relevant sind.
Auch die gesellschaftliche Dimension wird zunehmend wichtiger. Wenn Menschen nicht mehr zuverlässig erkennen können, ob sie mit einem Menschen oder einer KI kommunizieren, entstehen Fragen nach Transparenz und Vertrauen. Das betrifft beispielsweise automatisierte Kundenkommunikation, KI-generierte Inhalte und digitale Identitäten. In vielen Situationen ist nicht entscheidend, ob die Maschine einen Menschen imitieren kann, sondern ob Nutzer wissen, mit wem oder was sie interagieren.
Der Turing-Test bleibt damit ein wertvoller Denkanstoß, aber kein universeller Maßstab für die gesamte KI-Entwicklung. Er erinnert uns daran, dass intelligentes Verhalten nicht allein anhand der technischen Konstruktion beurteilt werden sollte. Gleichzeitig fordert uns die moderne KI dazu auf, über das ursprüngliche Experiment hinauszugehen und unterschiedliche Fähigkeiten mit geeigneten Methoden zu untersuchen.
Fazit: Wenn die Maschine menschlich wirkt, beginnt die eigentliche Frage
Der Turing-Test gehört zu den bekanntesten Ideen der Geschichte der künstlichen Intelligenz. Alan Turing entwickelte ihn aus der Überlegung heraus, dass die Frage nach maschinellem Denken konkreter untersucht werden sollte. Anstatt sich ausschließlich über die Definition von Intelligenz zu streiten, schlug er einen beobachtbaren Vergleich vor: Kann eine Maschine in einer Unterhaltung so überzeugend auftreten, dass ein Mensch sie nicht zuverlässig von einem anderen Menschen unterscheiden kann?
Diese Idee ist auch heute noch faszinierend. Moderne Sprachmodelle können anspruchsvolle Gespräche führen, Texte verfassen, Informationen zusammenfassen und auf komplexe Fragen reagieren. Damit sind sie in vielen sprachlichen Situationen deutlich leistungsfähiger als frühere Computersysteme. Dennoch beweist eine überzeugende Unterhaltung weder Bewusstsein noch menschliches Verständnis. Sie zeigt zunächst, dass ein System bestimmte sprachliche und kommunikative Leistungen erbringen kann.
Für die Praxis ergibt sich daraus eine wichtige Konsequenz. Wer künstliche Intelligenz beurteilen möchte, sollte nicht allein darauf achten, wie menschlich ihre Antworten wirken. Entscheidend ist vielmehr, ob sie die vorgesehene Aufgabe zuverlässig, nachvollziehbar und sicher erfüllt. Der Turing-Test kann dabei eine Perspektive liefern, muss aber durch weitere Prüfverfahren ergänzt werden.
Vielleicht liegt die eigentliche Bedeutung des Turing-Tests deshalb nicht darin, irgendwann eine endgültige Antwort auf die Frage nach maschinellem Denken zu liefern. Seine Stärke liegt darin, dass er uns zwingt, genauer über unsere Maßstäbe nachzudenken. Was halten wir für intelligent? Woran erkennen wir Verständnis? Und wie unterscheiden wir überzeugende Kommunikation von verlässlicher Leistung?
Eine Maschine kann menschlich wirken, ohne dass damit alle Fragen über ihre Intelligenz beantwortet wären. Aber wenn wir beginnen, ihre Fähigkeiten präzise zu untersuchen, lernen wir nicht nur mehr über künstliche Intelligenz. Wir lernen auch, unsere eigenen Vorstellungen von Denken, Sprache und Intelligenz kritisch zu hinterfragen.
FAQ: Häufig gestellte Fragen zum Turing-Test
Was versteht man unter dem Turing-Test?
Der Turing-Test ist ein von Alan Turing 1950 vorgeschlagenes Verfahren zur Untersuchung menschenähnlichen Verhaltens von Maschinen. Ein menschlicher Prüfer kommuniziert mit unbekannten Gesprächspartnern und soll beurteilen, ob sich darunter eine Maschine befindet. Kann die Maschine überzeugend genug antworten, sodass sie nicht zuverlässig vom Menschen unterschieden wird, spricht das für eine hohe Leistung in dieser konkreten Gesprächssituation. Es beweist jedoch nicht automatisch, dass die Maschine Bewusstsein oder menschliches Verständnis besitzt.
Wer hat den Turing-Test erfunden?
Der britische Mathematiker und Computerwissenschaftler Alan Turing entwickelte die Idee in seinem 1950 veröffentlichten Aufsatz „Computing Machinery and Intelligence“. Er wollte die schwer eindeutig zu beantwortende Frage, ob Maschinen denken können, durch eine konkretere Untersuchung ersetzen. Sein Imitationsspiel wurde zur Grundlage des später sogenannten Turing-Tests. Turings Arbeiten zählen zu den wichtigen Grundlagen der theoretischen Informatik und der frühen KI-Forschung.
Wie läuft ein Turing-Test ab?
Bei einer verbreiteten Variante kommuniziert ein menschlicher Prüfer über Text mit einem Menschen und einer Maschine, ohne ihre Identität zu kennen. Er stellt Fragen, bewertet die Antworten und versucht herauszufinden, welcher Gesprächspartner der Computer ist. Die Maschine versucht, möglichst überzeugend menschliches Gesprächsverhalten zu zeigen. Das Ergebnis hängt unter anderem von der Gesprächsdauer, den Fragen, den Bewertungskriterien und den Fähigkeiten der beteiligten Personen ab.
Hat ChatGPT den Turing-Test bestanden?
Das lässt sich nicht pauschal mit Ja oder Nein beantworten. Moderne Sprachmodelle können in bestimmten Gesprächen sehr menschlich wirken, doch unterschiedliche Turing-Test-Varianten verwenden unterschiedliche Bedingungen und Bewertungskriterien. Ein erfolgreiches Experiment belegt deshalb zunächst eine bestimmte Leistung unter den untersuchten Bedingungen. Es ist kein universeller Nachweis dafür, dass ein Sprachmodell in allen Gesprächen ununterscheidbar von Menschen wäre oder menschliches Bewusstsein besitzt.
Beweist der Turing-Test, dass eine KI intelligent ist?
Der Test liefert Hinweise darauf, wie überzeugend eine Maschine menschenähnliche sprachliche Leistungen erbringen kann. Er beantwortet jedoch nicht abschließend, was Intelligenz ist oder ob eine Maschine tatsächlich versteht, was sie sagt. Eine KI kann in einem Gespräch erfolgreich sein und trotzdem bei anderen Aufgaben erhebliche Schwächen zeigen. Für eine umfassende Bewertung müssen deshalb weitere Fähigkeiten wie Schlussfolgern, Zuverlässigkeit, Problemlösung und Robustheit untersucht werden.
Was ist der Unterschied zwischen dem Turing-Test und dem Chinesischen Zimmer?
Der Turing-Test untersucht, ob eine Maschine im Gespräch menschenähnliches Verhalten zeigen kann. Das Chinesische-Zimmer-Argument von John Searle hinterfragt dagegen, ob die Verarbeitung von Symbolen und die Erzeugung überzeugender Antworten bereits echtes Verständnis bedeuten. Searle argumentiert, dass ein System sprachlich passende Antworten liefern könnte, ohne die Bedeutung der verarbeiteten Zeichen zu verstehen. Die beiden Ansätze beleuchten somit unterschiedliche Aspekte der Frage, wie wir maschinelle Intelligenz beurteilen sollten.
Warum ist der Turing-Test für die heutige KI noch wichtig?
Der Turing-Test bietet einen historischen und konzeptionellen Ausgangspunkt, um menschenähnliche Kommunikation durch Maschinen zu untersuchen. Angesichts leistungsfähiger Sprachmodelle ist die Frage besonders relevant, wie Menschen maschinelle und menschliche Antworten unterscheiden und welche Schlüsse sie daraus ziehen. Gleichzeitig reicht der Test allein nicht aus, um die praktische Qualität einer KI zu beurteilen. Für den Einsatz in Unternehmen sind zusätzlich Zuverlässigkeit, Sicherheit, fachliche Korrektheit und Transparenz entscheidend.
Welche Grenzen hat der Turing-Test?
Der Test konzentriert sich auf menschenähnliches Verhalten in einer bestimmten Gesprächssituation. Seine Ergebnisse hängen von den Fragen, der Dauer, den Prüfern und den verwendeten Bewertungskriterien ab. Außerdem lässt sich aus überzeugenden Antworten nicht automatisch auf Bewusstsein oder tatsächliches Verständnis schließen. Für eine umfassende Bewertung künstlicher Intelligenz muss der Turing-Test deshalb durch weitere, auf konkrete Fähigkeiten und Einsatzgebiete abgestimmte Verfahren ergänzt werden.


