
Ein globaler Microsoft-Ausfall legt Outlook, Teams und weitere Microsoft-365-Dienste lahm. Was zunächst wie eine technische Störung aussieht, offenbart ein viel größeres Problem: die digitale Abhängigkeit moderner Unternehmen von einzelnen Technologieanbietern. Warum fehlende Fallback-Systeme ein Managementproblem sind, weshalb Homeoffice dafür nicht verantwortlich ist und wie Unternehmen ihre digitale Resilienz nachhaltig stärken können.
Wenn plötzlich nichts mehr geht: Willkommen im digitalen Stillstand
Donnerstagmorgen, kurz nach neun. Der erste Kaffee steht auf dem Schreibtisch, der Kalender ist voll, die ersten Meetings stehen an und eigentlich sollte der Arbeitstag gerade richtig Fahrt aufnehmen. Doch beim Öffnen von Microsoft Teams dreht sich nur noch das kleine Ladesymbol. Outlook reagiert nicht, E-Mails lassen sich nicht versenden und der Zugriff auf wichtige Dokumente funktioniert ebenfalls nur eingeschränkt. Ein kurzer Blick in den Browser bestätigt die Vermutung: Irgendetwas stimmt mit der Microsoft-Infrastruktur nicht. Willkommen im digitalen Stillstand!
Was sich zunächst wie eine gewöhnliche technische Störung anfühlt, kann sich innerhalb weniger Minuten zu einem ernsthaften betrieblichen Problem entwickeln. Mitarbeiter können sich nicht mehr abstimmen, Führungskräfte erreichen ihre Teams nicht und wichtige Entscheidungen bleiben liegen. Projektverantwortliche wissen möglicherweise nicht einmal, ob ihre Kollegen ebenfalls betroffen sind oder ob es sich um ein individuelles Problem handelt. Und während die IT-Abteilung versucht, die Ursache einzugrenzen, warten ganze Abteilungen darauf, dass die gewohnte Arbeitsumgebung wieder funktioniert.
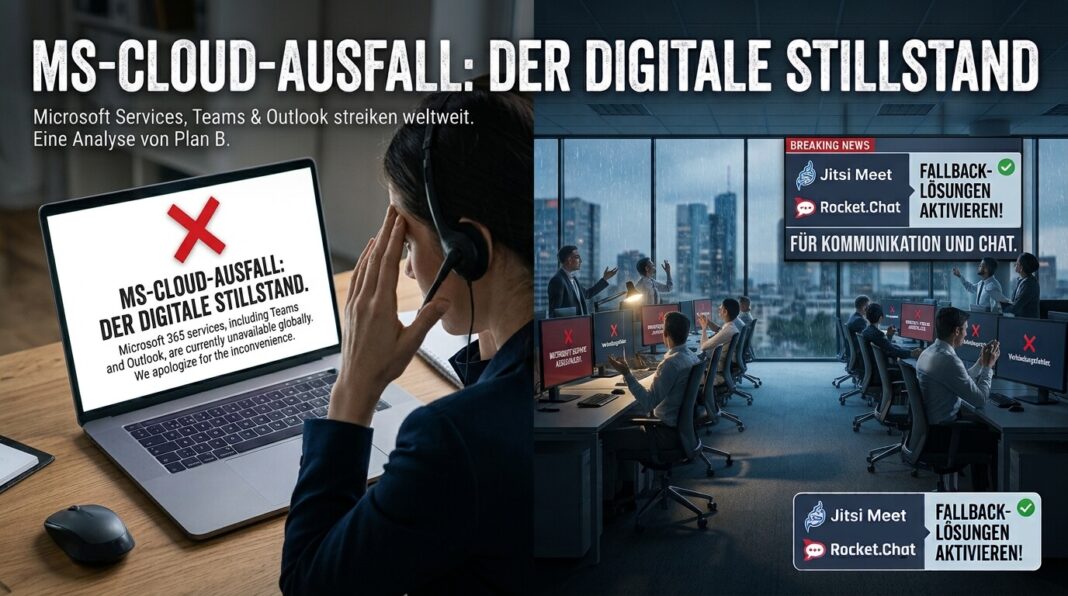
Genau dieses Szenario wurde Mitte November 2026 Realität. Ein weltweiter Ausfall von Microsoft 365 beeinträchtigte zwischen dem 12. und 14. November zahlreiche Dienste, darunter Outlook, Exchange Online, Teams, SharePoint und Copilot. Die Störung zog sich über mehr als 24 Stunden hin und betraf Unternehmen, Behörden und öffentliche Einrichtungen weltweit. Microsoft meldete erhebliche Infrastrukturprobleme und schloss nach eigenen Angaben einen böswilligen Cyberangriff als Ursache aus. Die Wiederherstellung erfolgte schrittweise, während unter anderem aufgelaufene E-Mail-Warteschlangen abgearbeitet werden mussten. Das Ausmaß dieser Störung verdeutlicht, wie weitreichend die Folgen sein können, wenn zentrale Cloud-Dienste gleichzeitig nicht zuverlässig funktionieren.
Doch hier beginnt die eigentlich spannende Diskussion. Ein Cloud-Ausfall ist zunächst einmal ein technisches Ereignis. Dass ein Unternehmen deshalb aber stundenlang oder sogar einen ganzen Arbeitstag weitgehend handlungsunfähig wird, ist keine zwangsläufige Folge. Es ist vielmehr ein Hinweis darauf, dass sich die Organisation möglicherweise nie ernsthaft mit alternativen Betriebswegen beschäftigt hat.
Die entscheidende Frage lautet deshalb nicht, warum Microsoft ausgefallen ist. Sie lautet: Warum können manche Unternehmen ohne Microsoft nicht mehr arbeiten?
Die unsichtbare Gefahr der digitalen Monokultur
Viele Unternehmen haben ihre digitale Arbeitsumgebung über Jahre hinweg konsequent auf Microsoft ausgerichtet. Das ist nachvollziehbar. Microsoft 365 bietet eine umfangreiche Produktpalette, eine zentrale Benutzerverwaltung, zahlreiche Integrationsmöglichkeiten und eine vergleichsweise komfortable Administration. Teams kommunizieren über Microsoft Teams, E-Mails laufen über Exchange Online, Dokumente liegen in SharePoint oder OneDrive und die Benutzeridentitäten werden über Microsoft Entra ID verwaltet.
Auf den ersten Blick wirkt das wie eine wunderbar integrierte Plattform. Alles greift ineinander, Benutzer müssen sich nicht ständig neu anmelden und Informationen lassen sich bequem zwischen verschiedenen Anwendungen austauschen. Doch genau diese Integration birgt ein Risiko, das im normalen Arbeitsalltag kaum jemand wahrnimmt. Je stärker die einzelnen Geschäftsprozesse miteinander verbunden sind, desto größer können die Auswirkungen einer Störung innerhalb einer zentralen Abhängigkeit werden.
In der IT-Architektur spricht man in diesem Zusammenhang unter anderem von einem Single Point of Failure. Gemeint ist eine einzelne Komponente oder Abhängigkeit, deren Ausfall einen erheblichen Teil eines Gesamtsystems beeinträchtigen kann. Eine digitale Monokultur entsteht dann, wenn nicht nur einzelne Anwendungen, sondern ganze Geschäftsprozesse von einem Anbieter und dessen Infrastruktur abhängig sind.
Dabei sollte man allerdings technisch sauber unterscheiden: Nicht jeder Ausfall eines Microsoft-Dienstes legt automatisch sämtliche anderen Dienste lahm. Auch innerhalb von Microsoft 365 existieren unterschiedliche Dienste, Regionen, Infrastrukturkomponenten und Fehlerdomänen. Der November-Ausfall zeigte jedoch, dass sich Störungen über gemeinsame Infrastruktur und technische Abhängigkeiten auf mehrere Produkte auswirken können.
Wenn Kommunikation, Identität und Daten am selben Tropf hängen
Besonders kritisch wird es, wenn mehrere geschäftskritische Funktionen aufeinander aufbauen. Ein Unternehmen kann beispielsweise einen alternativen Messenger betreiben und trotzdem keinen Zugriff darauf erhalten, wenn dessen Anmeldung ausschließlich über den ausgefallenen zentralen Identitätsdienst funktioniert. Ebenso wenig hilft ein unabhängiger Dateispeicher, wenn sämtliche Zugänge und Berechtigungen über eine nicht erreichbare zentrale Authentifizierung gesteuert werden.
Betrachten wir die typischen Abhängigkeiten etwas genauer:
- Kommunikation über Microsoft Teams: Teams ist für viele Unternehmen längst mehr als ein Videokonferenzwerkzeug. Es dient als zentraler Kommunikationskanal, über den Projektteams Informationen austauschen, Entscheidungen vorbereiten, Aufgaben koordinieren und teilweise sogar operative Prozesse steuern. Fällt Teams aus, fehlen häufig nicht nur Besprechungsmöglichkeiten, sondern auch wichtige Informationen aus Chats und Kanälen. Besonders problematisch wird es, wenn alternative Kommunikationswege nie etabliert wurden. Dann wissen Mitarbeiter im Ernstfall schlicht nicht, wie sie ihre Kollegen erreichen sollen.
- E-Mail über Outlook und Exchange Online: E-Mail ist in vielen Organisationen nach wie vor ein geschäftskritischer Kommunikationskanal. Kundenanfragen, Lieferantenkommunikation, Freigaben, Bestellungen und externe Abstimmungen laufen darüber. Ist Exchange Online nicht erreichbar oder arbeitet nur eingeschränkt, können Informationen weder zuverlässig empfangen noch versendet werden. Besonders unangenehm ist das bei zeitkritischen Geschäftsprozessen, beispielsweise im Kundenservice oder in der Auftragsabwicklung. Eine alternative Kommunikationsmöglichkeit muss deshalb auch außerhalb der primären E-Mail-Infrastruktur funktionieren.
- Dateispeicherung über SharePoint und OneDrive: Dokumente, Prozessbeschreibungen, Projektunterlagen und Arbeitsanweisungen liegen häufig ausschließlich in der Microsoft-Cloud. Das ist im Normalbetrieb praktisch, kann im Störungsfall jedoch zum Problem werden. Ohne Zugriff auf wichtige Unterlagen fehlen möglicherweise Arbeitsgrundlagen, technische Dokumentationen und verbindliche Prozessinformationen. Selbst ein funktionierender Kommunikationskanal bringt wenig, wenn die Mitarbeiter nicht an die benötigten Dokumente gelangen. Kritische Informationen müssen deshalb auch unabhängig von der primären Cloud verfügbar sein.
- Identitätsmanagement über Microsoft Entra ID: Die zentrale Benutzerverwaltung ist ein besonders sensibler Bestandteil der Architektur. Sie ermöglicht Authentifizierung, Zugriffskontrolle und die Integration verschiedener Anwendungen. Wird ein alternativer Dienst ausschließlich über dieselbe Identitätsinfrastruktur abgesichert, entsteht eine Abhängigkeit, die im Notfall schnell übersehen wird. Ein Fallback muss deshalb auch dann erreichbar sein, wenn die primäre Authentifizierungsumgebung Probleme bereitet. Das bedeutet keineswegs, dass Unternehmen ihre Identitätsverwaltung vollständig doppelt betreiben müssen, wohl aber, dass Notfallzugänge und alternative Authentifizierungsverfahren durchdacht sein sollten.
Das eigentliche Problem ist also nicht die Nutzung von Microsoft. Das Problem ist die fehlende Fähigkeit, bei einer Störung unabhängig von Microsoft weiterzuarbeiten.
Ist wieder das Homeoffice schuld? Eine ziemlich bequeme Ausrede!
Es dürfte nicht lange dauern, bis nach einem größeren Cloud-Ausfall die üblichen Diskussionen wieder beginnen. Vielleicht hätten die Mitarbeiter im Büro wenigstens miteinander sprechen können. Vielleicht wäre die Kommunikation vor Ort einfacher gewesen. Vielleicht sei das Homeoffice grundsätzlich ein Risiko für die Produktivität.
Solche Argumentationen klingen auf den ersten Blick plausibel, greifen bei genauer Betrachtung aber deutlich zu kurz. Sie verwechseln nämlich den Arbeitsort mit der technischen Infrastruktur, die für die Zusammenarbeit benötigt wird. Ein Unternehmen, das seine Kommunikations- und Arbeitsprozesse vollständig digitalisiert hat, bleibt auch dann von diesen Systemen abhängig, wenn sämtliche Mitarbeiter im selben Gebäude sitzen.
Ich kenne die Realität moderner Unternehmen durchaus aus unterschiedlichen Perspektiven. Gerade in größeren Organisationen arbeiten Teams häufig standortübergreifend, teilweise sogar über Ländergrenzen hinweg. Der Kollege aus Karlsruhe sitzt vielleicht im Büro, seine Projektpartner befinden sich in München, Hamburg oder einem internationalen Entwicklungsstandort. Was genau soll ihm das Büro in dieser Situation bringen, wenn die zentrale Kommunikationsplattform nicht funktioniert?
Das Büro ist kein Ersatz für eine funktionierende IT-Infrastruktur
Selbst wenn sämtliche Mitarbeiter an einem Standort arbeiten, ist die Vorstellung einer spontanen Rückkehr zur analogen Zusammenarbeit häufig romantischer als die Realität. In vielen Unternehmen werden Meetings inzwischen grundsätzlich digital organisiert. Das hat durchaus praktische Gründe. Mitarbeiter müssen nicht ständig zwischen verschiedenen Besprechungsräumen wechseln, können sich direkt aus ihrem Arbeitsbereich zuschalten und sparen dadurch unnötige Wegezeiten.
Wer regelmäßig in größeren Organisationen gearbeitet hat, kennt das Spiel: Ein Meeting endet, der nächste Termin beginnt fünf Minuten später und der Besprechungsraum befindet sich selbstverständlich am anderen Ende des Gebäudes. Während die Teilnehmer noch durch die Flure laufen, wartet die nächste Gruppe bereits auf den Raum. Da ist es oftmals effizienter, die Besprechung direkt digital durchzuführen.
Und wenn Teams ausfällt, wird aus dem vermeintlichen Vorteil des gemeinsamen Standorts plötzlich ein organisatorisches Problem. Es gibt keine zentrale Möglichkeit, standortübergreifende Besprechungen durchzuführen, Projektinformationen auszutauschen oder kurzfristige Entscheidungen mit externen Kollegen abzustimmen.
Das Homeoffice ist also nicht die Ursache des Problems. Es macht lediglich sichtbar, wie stark Unternehmen ihre Arbeitsfähigkeit von einer funktionierenden digitalen Infrastruktur abhängig gemacht haben.
Wer die Rückkehr ins Büro als Lösung für einen Cloud-Ausfall verkauft, behandelt das Symptom und ignoriert die eigentliche Ursache.
Die IT kennt die Risiken – aber wer bezahlt eigentlich die Sicherheit?
Jetzt kommen wir zu einem Punkt, der in vielen Unternehmen unangenehm werden dürfte. Die Verantwortung für die digitale Resilienz wird gerne der IT-Abteilung zugeschoben. Wenn ein System ausfällt, soll die IT erklären, warum das passiert ist und wie sich ein solcher Vorfall künftig verhindern lässt.
Dabei wird häufig übersehen, dass IT-Abteilungen die Risiken durchaus kennen. Administratoren, Architekten, Security-Verantwortliche und Business Engineers beschäftigen sich regelmäßig mit Verfügbarkeit, Ausfallsicherheit, Wiederherstellungszeiten und technischen Abhängigkeiten. Sie wissen, dass es keine hundertprozentige Ausfallsicherheit gibt und dass kritische Systeme entsprechende Vorkehrungen benötigen.
Das eigentliche Problem entsteht häufig an einer anderen Stelle: bei der Priorisierung und Budgetierung. Eine zusätzliche Infrastruktur kostet Geld. Ein zweites Kommunikationssystem verursacht Lizenz-, Hosting- und Administrationsaufwand. Eine unabhängige Backup-Umgebung muss gepflegt, getestet und abgesichert werden. Und regelmäßige Notfallübungen beanspruchen Arbeitszeit, die sich nicht unmittelbar in einem zusätzlichen Umsatz niederschlägt.
In Budgetgesprächen lässt sich deshalb schnell eine scheinbar vernünftige Argumentation konstruieren: Warum sollen wir Geld für ein zweites System ausgeben, wenn das erste doch zuverlässig funktioniert? Warum brauchen wir einen alternativen Messenger, wenn Teams bereits vorhanden ist? Warum sollen wir zusätzliche Ressourcen für einen Notfall vorhalten, der vielleicht niemals eintritt?
Das ist ungefähr so, als würde man bei einem Unternehmen die Feuerversicherung kündigen, weil das Gebäude schließlich seit 20 Jahren nicht gebrannt hat.
Falsche Sparsamkeit wird im Ernstfall richtig teuer
Aus meiner beruflichen Erfahrung weiß ich, wie häufig technische Empfehlungen und wirtschaftliche Entscheidungen auseinanderlaufen können. Die IT betrachtet Risiken aus einer technischen und operativen Perspektive. Das Management bewertet Investitionen dagegen häufig anhand kurzfristig sichtbarer Kosten und erwarteter Einsparungen.
Natürlich muss nicht jedes Unternehmen für jede Anwendung eine vollständig redundante Infrastruktur betreiben. Das wäre wirtschaftlich weder sinnvoll noch notwendig. Entscheidend ist vielmehr, welche Geschäftsprozesse kritisch sind und welche Auswirkungen deren Ausfall hätte.
Ein kleines Unternehmen mit zehn Mitarbeitern hat andere Anforderungen als ein international tätiger Konzern mit mehreren Tausend Beschäftigten. Aber auch ein mittelständischer Betrieb kann durch einen mehrstündigen Ausfall erhebliche wirtschaftliche Schäden erleiden. Wenn Vertrieb, Kundenservice, Projektsteuerung und interne Kommunikation gleichzeitig beeinträchtigt sind, summieren sich die Kosten schnell.
Nehmen wir ein einfaches Rechenbeispiel: Ein Unternehmen beschäftigt 500 Mitarbeiter. Bei durchschnittlichen Vollkosten von 45 Euro pro Arbeitsstunde entstehen bereits 22.500 Euro Personalkosten pro Stunde. Wenn ein erheblicher Teil der Belegschaft aufgrund fehlender Fallback-Systeme vier Stunden nicht produktiv arbeiten kann, entspricht das rechnerisch 90.000 Euro gebundener Arbeitskapazität.
Dabei sind mögliche Folgekosten noch gar nicht berücksichtigt. Verzögerte Kundenaufträge, verpasste Liefertermine, Vertragsstrafen, Umsatzausfälle und Reputationsschäden können die wirtschaftlichen Auswirkungen deutlich erhöhen. Natürlich ist nicht jede Stunde eines Ausfalls automatisch eine vollständig verlorene Arbeitsstunde. Mitarbeiter können teilweise auf andere Tätigkeiten ausweichen. Genau das funktioniert allerdings nur, wenn die Organisation entsprechende Alternativen vorbereitet hat.
Redundanz ist deshalb keine Verschwendung. Sie ist eine Versicherung gegen den Verlust der eigenen Handlungsfähigkeit.
Und noch etwas: Die IT kann technische Risiken identifizieren, Konzepte entwickeln und Lösungen bereitstellen. Sie kann aber nicht eigenständig entscheiden, ob das Unternehmen dafür Geld ausgeben möchte. Diese Verantwortung liegt letztlich bei denjenigen, die Budgets und strategische Prioritäten festlegen.
Der digitale Notfall-Koffer: So funktioniert ein Plan B wirklich
Ein vernünftiges Notfallkonzept muss nicht bedeuten, dass Unternehmen ihre gesamte IT-Infrastruktur doppelt aufbauen. Vielmehr geht es darum, für ausgewählte geschäftskritische Prozesse alternative Betriebswege zu schaffen.
Der erste Schritt besteht darin, zwischen normalen Arbeitsabläufen und absoluten Mindestanforderungen im Notfall zu unterscheiden. Während eines regulären Arbeitstages benötigen Mitarbeiter möglicherweise sämtliche Funktionen von Teams, SharePoint und Outlook. Im Krisenfall reicht es dagegen zunächst, wenn sie sich gegenseitig erreichen, wichtige Informationen austauschen und kritische Entscheidungen treffen können.
Genau hier kommen unabhängige Fallback-Systeme ins Spiel. Interessanterweise existieren dafür längst leistungsfähige Open-Source-Lösungen, die Unternehmen selbst betreiben oder bei unabhängigen Hosting-Anbietern betreiben lassen können.
Jitsi Meet: Videokonferenzen unabhängig von Teams
Jitsi Meet ist eine Open-Source-Lösung für Videokonferenzen, die sich vergleichsweise unkompliziert einsetzen lässt. Unternehmen können eine eigene Instanz betreiben und damit einen alternativen Kommunikationskanal für Besprechungen bereitstellen. Gerade für kurzfristige Abstimmungen ist das interessant, weil Teilnehmer nicht zwingend einen vollständig eingerichteten Unternehmenskonto-Zugang benötigen. Die Lösung unterstützt Audio- und Videokonferenzen sowie Bildschirmfreigaben und eignet sich damit für viele typische Besprechungsszenarien. Wichtig ist allerdings, dass Hosting, Zugangsschutz, Kapazitäten und technische Erreichbarkeit bereits vor einem Ausfall organisiert wurden.
Eine selbst betriebene Jitsi-Instanz kann beispielsweise auf einer unabhängigen Hosting-Infrastruktur laufen. Entscheidend ist dabei, dass sie nicht über dieselben kritischen Komponenten erreichbar sein muss wie die primäre Microsoft-Umgebung. Wer Jitsi lediglich als zusätzliche Anwendung innerhalb derselben Cloud- und Identitätsabhängigkeiten betreibt, hat zwar eine weitere Software installiert, aber noch keine echte Unabhängigkeit geschaffen.
Rocket.Chat, Matrix und Mattermost: Kommunikation braucht einen zweiten Weg
Rocket.Chat, Matrix und Mattermost bieten unterschiedliche Möglichkeiten, eine alternative Kommunikationsinfrastruktur aufzubauen.
Rocket.Chat ermöglicht eine teamorientierte Kommunikation mit Kanälen, Direktnachrichten und Integrationsmöglichkeiten. Mattermost richtet sich insbesondere an Unternehmen, die strukturierte Teamkommunikation und technische Integrationen benötigen. Matrix verfolgt dagegen einen dezentralen Ansatz, bei dem unterschiedliche Server miteinander kommunizieren können. In Verbindung mit einem Client wie Element entsteht damit eine flexible Kommunikationsumgebung, die nicht zwingend von einem einzelnen zentralen Anbieter abhängig sein muss.
Welche Lösung sinnvoll ist, hängt von den Anforderungen des Unternehmens ab. Entscheidend ist weniger die Frage, welcher Messenger die meisten Funktionen bietet, sondern welcher im Notfall zuverlässig funktioniert und unabhängig von der primären Infrastruktur betrieben werden kann.
Auch hier gilt: Ein Fallback-Messenger ist nur dann ein Fallback, wenn er tatsächlich erreichbar ist. Werden sämtliche Benutzerkonten ausschließlich über Microsoft Entra ID authentifiziert oder liegt der Server beim selben Cloud-Anbieter in derselben kritischen Fehlerdomäne, kann die vermeintliche Unabhängigkeit schnell verpuffen.
Weitere Bausteine für einen funktionierenden Notfallbetrieb
Ein belastbares Notfallkonzept besteht allerdings aus mehr als zwei alternativen Anwendungen. Unternehmen sollten mehrere technische und organisatorische Maßnahmen miteinander kombinieren.
- Unabhängige Notfall-Kommunikation: Ein SMS-Gateway, eine externe Telefonkonferenzlösung oder ein unabhängiger Kommunikationskanal kann helfen, Mitarbeiter auch dann zu erreichen, wenn Teams und Outlook nicht funktionieren. Besonders wichtig ist eine Möglichkeit, die nicht von derselben Authentifizierungs- oder Netzwerkkomponente abhängt. Führungskräfte und Krisenverantwortliche sollten über hinterlegte Kontaktinformationen verfügen. Dabei müssen Datenschutz, Zugriffsschutz und die Aktualität der Kontaktdaten berücksichtigt werden. Eine solche Infrastruktur sollte regelmäßig getestet werden, damit sie nicht ausgerechnet im Ernstfall selbst zum Problem wird.
- Offline verfügbare Dokumentationen: Kritische Notfallpläne, Kontaktlisten, Prozessbeschreibungen und technische Wiederherstellungsanweisungen sollten nicht ausschließlich in SharePoint oder OneDrive liegen. Eine verschlüsselte, lokal verfügbare Kopie kann im Krisenfall entscheidend sein. Dazu gehören auch Informationen über Systemverantwortliche, Eskalationswege und alternative Zugangsmöglichkeiten. Die Dokumente müssen versioniert und regelmäßig aktualisiert werden. Veraltete Notfallinformationen können im Ernstfall genauso gefährlich sein wie überhaupt keine Dokumentation.
- Unabhängige Status- und Informationsseiten: Eine separate Status-Seite ermöglicht es IT-Verantwortlichen, Mitarbeiter über den aktuellen Stand einer Störung zu informieren. Sie sollte außerhalb der primären Infrastruktur betrieben werden und ohne Anmeldung erreichbar sein. Dort können Informationen zu betroffenen Diensten, verfügbaren Alternativen und erwarteten nächsten Schritten veröffentlicht werden. Auch Kunden lassen sich über solche Seiten informieren, wenn externe Services betroffen sind. Entscheidend ist, dass die Status-Seite nicht ebenfalls von der ausgefallenen Plattform abhängig ist.
- Regelmäßige Notfallübungen: Ein Fallback-Konzept ist nur so gut wie seine praktische Funktionsfähigkeit. Unternehmen sollten deshalb regelmäßig sogenannte Fire Drills durchführen, bei denen gezielt einzelne Dienste oder Kommunikationswege als nicht verfügbar angenommen werden. Mitarbeiter müssen wissen, wo sie alternative Informationen finden und wie sie ihre Kollegen erreichen. Die Übungen sollten nicht ausschließlich auf die IT beschränkt sein, sondern auch Fachabteilungen und Führungskräfte einbeziehen. Erst durch regelmäßige Tests zeigt sich, ob ein Notfallkonzept tatsächlich funktioniert oder lediglich in einer PowerPoint-Präsentation existiert.
Digitale Souveränität ist keine politische Floskel, sondern eine wirtschaftliche Notwendigkeit
Die Diskussion um digitale Souveränität wird häufig auf Datenschutz, europäische Anbieter und geopolitische Abhängigkeiten reduziert. Das sind zweifellos wichtige Aspekte. Doch digitale Souveränität bedeutet noch etwas anderes: die Fähigkeit eines Unternehmens, seine eigenen digitalen Geschäftsprozesse auch dann kontrollieren und aufrechterhalten zu können, wenn ein bestimmter Technologieanbieter nicht verfügbar ist.
Es geht also nicht darum, Microsoft grundsätzlich zu verteufeln oder sämtliche vorhandenen Systeme durch europäische Open-Source-Alternativen zu ersetzen. Microsoft 365 ist für viele Unternehmen eine leistungsfähige Plattform, die im Alltag erhebliche Vorteile bietet. Aber eine strategische Abhängigkeit entsteht dort, wo es keine realistische Alternative mehr gibt und ein Anbieterwechsel oder eine zeitweise Entkopplung praktisch unmöglich erscheint.
Gerade europäische und deutsche Unternehmen sollten deshalb genauer hinschauen. Es gibt mittlerweile zahlreiche leistungsfähige Alternativen in den Bereichen Collaboration, Identitätsmanagement, Dokumentenverwaltung, Kommunikation und Infrastruktur. Nicht jede Lösung eignet sich für jeden Anwendungsfall, und auch Open Source ist kein automatischer Garant für Sicherheit, Verfügbarkeit oder Unabhängigkeit. Aber die Möglichkeiten sind vorhanden und verdienen eine ernsthafte Prüfung.
Drei konkrete Schritte für mehr digitale Resilienz
Für Entscheider, IT-Verantwortliche und Business Engineers ergeben sich daraus drei zentrale Handlungsfelder.
1. Abhängigkeiten systematisch auditieren
Der erste Schritt besteht darin, die eigene IT-Landschaft nicht nur nach Anwendungen, sondern nach tatsächlichen Abhängigkeiten zu betrachten. Welche Geschäftsprozesse benötigen Teams, Exchange Online oder SharePoint? Welche Systeme verwenden Microsoft Entra ID für die Anmeldung? Wo befinden sich Daten, Backups und technische Dokumentationen? Und welche dieser Komponenten können bei einem größeren Infrastrukturproblem gleichzeitig betroffen sein?
Ein solches Abhängigkeitsaudit sollte gemeinsam mit den Fachbereichen durchgeführt werden. Denn die IT kennt zwar die technische Architektur, aber nicht immer sämtliche operativen Konsequenzen eines Ausfalls. Besonders wichtig ist die Identifikation geschäftskritischer Prozesse und deren maximal tolerierbarer Ausfallzeit. Daraus lassen sich konkrete Anforderungen an Wiederherstellungszeiten und Datenverfügbarkeit ableiten. Das Ergebnis sollte eine nachvollziehbare Übersicht über kritische Abhängigkeiten und mögliche Ausweichszenarien sein.
2. Digitale Souveränität strategisch nutzen
Im zweiten Schritt sollten Unternehmen prüfen, welche geschäftskritischen Funktionen sich durch unabhängige oder alternative Lösungen absichern lassen. Dabei müssen nicht sofort sämtliche Systeme ausgetauscht werden. Schon ein zusätzlicher Kommunikationskanal, eine unabhängige Videokonferenzlösung oder ein alternativer Dokumentenzugriff kann die Widerstandsfähigkeit erheblich verbessern.
Europäische Anbieter und Open-Source-Projekte verdienen dabei besondere Aufmerksamkeit. Lösungen wie Nextcloud, Jitsi, Matrix oder Mattermost können je nach Einsatzgebiet interessante Alternativen darstellen. Wichtig ist eine ehrliche Bewertung hinsichtlich Betrieb, Sicherheit, Wartung, Support und Integrationsfähigkeit. Eine Software ist nicht automatisch besser, nur weil ihr Quellcode öffentlich verfügbar ist. Aber Unternehmen sollten sich auch nicht aus Bequemlichkeit ausschließlich auf einen einzigen Anbieter verlassen.
3. Fallback-Systeme verbindlich budgetieren und etablieren
Der dritte Schritt ist vermutlich der schwierigste, weil er eine Veränderung der Managementperspektive erfordert. Notfallinfrastrukturen dürfen nicht als optionale Zusatzkosten betrachtet werden, die bei der nächsten Budgetrunde wieder gestrichen werden können. Sie müssen Bestandteil der Business-Continuity-Planung und des Risikomanagements sein.
Dazu gehören klar definierte Verantwortlichkeiten, dokumentierte Wiederherstellungsprozesse und regelmäßig getestete Alternativsysteme. Ebenso wichtig ist die Schulung der Mitarbeiter, damit sie im Ernstfall nicht erst herausfinden müssen, welche Lösung überhaupt verwendet werden soll. Das Management sollte außerdem konkrete Kennzahlen definieren, beispielsweise maximale Ausfallzeiten und Wiederherstellungsziele für besonders kritische Geschäftsprozesse. Erst wenn diese Anforderungen in Budgets, Verantwortlichkeiten und Prozesse übersetzt werden, entsteht echte organisatorische Resilienz.
Der nächste Ausfall kommt bestimmt – die Frage ist nur, ob wir vorbereitet sind
Der Microsoft-Ausfall im November 2026 sollte für Unternehmen mehr sein als eine kurzfristige Unannehmlichkeit, über die man sich zwei Tage ärgert und anschließend wieder zur Tagesordnung übergeht. Er ist ein eindrückliches Beispiel dafür, wie stark die moderne Arbeitswelt von wenigen zentralen Technologieanbietern abhängig geworden ist.
Dabei wäre es falsch, Microsoft allein für die entstandenen Probleme verantwortlich zu machen. Selbst hochverfügbare Cloud-Infrastrukturen können ausfallen. Komplexe Systeme bestehen aus zahlreichen miteinander verbundenen Komponenten, und auch umfangreiche Redundanzkonzepte können nicht jede Störung verhindern. Die eigentliche Verantwortung eines Unternehmens besteht deshalb darin, sich auf solche Ereignisse vorzubereiten.
Wer seine gesamte Kommunikation, Dokumentenverwaltung und Zusammenarbeit auf eine einzige Plattform konzentriert, muss sich zumindest mit den Konsequenzen beschäftigen. Das gilt für internationale Konzerne ebenso wie für mittelständische Unternehmen und kleinere Organisationen. Gerade im Mittelstand kann die Abhängigkeit von wenigen zentralen Systemen besonders kritisch werden, weil häufig keine großen internen IT-Teams vorhanden sind, die kurzfristig alternative Betriebswege aufbauen können.
Was mich an solchen Ereignissen besonders beschäftigt, ist die Diskrepanz zwischen dem hohen Digitalisierungsgrad vieler Unternehmen und ihrer tatsächlichen Krisenfestigkeit. Wir sprechen über künstliche Intelligenz, Automatisierung, digitale Transformation und vollständig integrierte Geschäftsprozesse. Gleichzeitig scheitert die Zusammenarbeit teilweise daran, dass ein Kommunikationsdienst nicht erreichbar ist. Das ist ein Widerspruch, den wir ernst nehmen sollten.
Digitalisierung bedeutet nicht, möglichst viele Prozesse in eine Cloud zu verlagern. Digitalisierung bedeutet auch, die eigene Handlungsfähigkeit unter schwierigen Bedingungen sicherzustellen.
Und vielleicht ist genau das die wichtigste Erkenntnis aus diesem Ausfall: Ein Unternehmen ist nicht deshalb digital souverän, weil es Microsoft 365, eine moderne Cloud-Plattform oder die neueste KI-Lösung verwendet. Es ist digital souverän, wenn es selbst dann noch handlungsfähig bleibt, wenn diese Technologien vorübergehend nicht zur Verfügung stehen.
Und wie lief der Microsoft-Ausfall bei euch ab?
Mich würde interessieren, wie Unternehmen und Mitarbeiter diesen Ausfall erlebt haben. Gab es bei euch einen vorbereiteten Plan B? Konntet ihr auf alternative Kommunikationswege ausweichen, weiterhin auf wichtige Dokumente zugreifen und eure geschäftskritischen Prozesse aufrechterhalten?
Oder hieß es letztlich: Zwangspause, Kaffee holen und warten, bis Microsoft wieder funktioniert?
Vielleicht hat der Ausfall auch bei euch eine Diskussion darüber ausgelöst, wie abhängig eure Organisation tatsächlich von einzelnen Cloud-Anbietern geworden ist. Wenn ja, wäre das zumindest ein positiver Nebeneffekt einer ansonsten ziemlich unangenehmen Erfahrung.
Meine Frage an euch: Wie resilient ist eure digitale Arbeitsumgebung wirklich und was passiert bei euch, wenn morgen nicht nur Teams, sondern gleich die gesamte Microsoft-365-Infrastruktur ausfällt?
Denn eines sollte spätestens jetzt klar sein: Ein Plan B ist kein Luxus. Er ist Teil einer verantwortungsvollen Unternehmensführung.