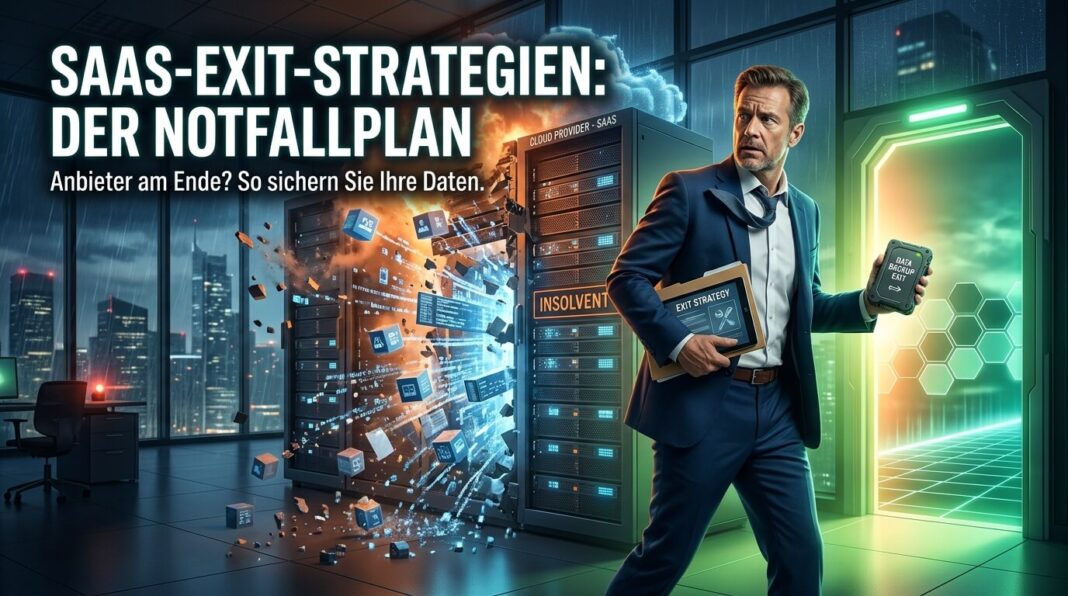

Warum Unternehmen einen Plan B brauchen, bevor aus der Cloud-Abhängigkeit ein geschäftskritischer Albtraum wird.
Die Cloud ist bequem. Bis sie plötzlich nicht mehr da ist.
Cloud Computing hat die Unternehmens-IT revolutioniert. Anwendungen lassen sich innerhalb weniger Stunden bereitstellen, Infrastruktur muss nicht mehr vollständig selbst betrieben werden und neue Funktionen stehen häufig automatisch zur Verfügung. Statt hohe Investitionen in eigene Serverlandschaften zu tätigen, bezahlen Unternehmen monatliche oder jährliche Nutzungsgebühren und können ihre Ressourcen flexibel skalieren. Software-as-a-Service (SaaS) ist damit für viele Organisationen längst nicht mehr nur eine technische Option, sondern ein fundamentaler Bestandteil ihrer Digitalisierungsstrategie geworden.
Doch diese Bequemlichkeit hat eine Schattenseite, über die erstaunlich selten gesprochen wird: Unternehmen geben einen Teil ihrer operativen Kontrolle an externe Anbieter ab. Daten, Geschäftsprozesse, Kommunikation, Dokumentationen und teilweise sogar das unternehmensinterne Wissen liegen plötzlich in Systemen, deren technische Verfügbarkeit und wirtschaftliche Zukunft andere bestimmen. Solange alles funktioniert, ist das kein Problem. Schwierig wird es, wenn der Anbieter seine Geschäftstätigkeit einstellt, ein Produkt abkündigt, insolvent wird oder nach einer Übernahme plötzlich eine völlig andere Produktstrategie verfolgt.
Dabei muss es nicht einmal zur Insolvenz kommen. Ein Anbieter kann seine Preise drastisch erhöhen, wichtige Funktionen aus seinem bisherigen Tarif entfernen oder die technische Architektur so verändern, dass bestehende Integrationen nicht mehr funktionieren. Auch schwere Sicherheitsvorfälle können dazu führen, dass ein Dienst kurzfristig oder dauerhaft nicht mehr genutzt werden darf. Besonders unangenehm wird es, wenn ein Unternehmen erst in diesem Moment feststellt, dass es weder einen vollständigen Datenexport noch eine realistische Migrationsmöglichkeit gibt.
Das eigentliche Problem ist also nicht die Cloud selbst, sondern eine fehlende Ausstiegsfähigkeit. Wer seine geschäftskritischen Prozesse vollständig von einem SaaS-Anbieter abhängig macht, ohne einen alternativen Betriebsweg vorzubereiten, baut eine digitale Einbahnstraße. Eine professionelle SaaS-Exit-Strategie sorgt dafür, dass diese Einbahnstraße im Ernstfall eine Ausfahrt besitzt.
Und genau darum geht es: nicht darum, jedes Cloud-Angebot grundsätzlich infrage zu stellen, sondern darum, die eigene digitale Handlungsfähigkeit zu bewahren.
Phase 1 – Prävention und Risikoanalyse: Der Ernstfall beginnt lange vor dem Ausfall
Eine funktionierende Exit-Strategie entsteht nicht während einer Krise. Sie beginnt mit einer ehrlichen Bestandsaufnahme der eigenen IT-Landschaft. Viele Unternehmen wissen zwar, welche Software sie einsetzen, haben aber keinen vollständigen Überblick darüber, welche Geschäftsprozesse tatsächlich von welchen Anwendungen abhängen. Besonders in größeren Organisationen entstehen über die Jahre zahlreiche Schattenlösungen, Fachbereichsanwendungen und zusätzliche SaaS-Abonnements, die teilweise außerhalb der zentralen IT-Beschaffung abgeschlossen wurden.
Genau hier setzt ein SaaS-Audit an. Ziel ist es, nicht einfach eine Liste aller Anwendungen zu erstellen, sondern deren tatsächliche Bedeutung für das Unternehmen zu bewerten. Eine Anwendung, deren Ausfall lediglich einige Mitarbeiter in ihrer täglichen Arbeit einschränkt, ist anders zu behandeln als ein System, über das Kundenaufträge, Rechnungen, Produktionsprozesse oder geschäftskritische Kommunikation abgewickelt werden. Die Bewertung muss deshalb immer aus Sicht der Geschäftsprozesse erfolgen und darf sich nicht ausschließlich an technischen Kriterien orientieren.
Besonders wichtig ist dabei die Abhängigkeit zwischen verschiedenen Anwendungen. Ein CRM-System kann beispielsweise weiterhin erreichbar sein, während eine angebundene Schnittstelle zum ERP-System ausgefallen ist. Technisch betrachtet funktioniert die Anwendung dann noch, operativ ist der Geschäftsprozess jedoch möglicherweise unterbrochen. Wer solche Abhängigkeiten nicht kennt, unterschätzt das tatsächliche Ausfallrisiko erheblich.
Das SaaS-Audit – Welche Anwendungen sind wirklich geschäftskritisch?
Für eine belastbare Bewertung empfiehlt sich eine Klassifizierung anhand von vier Kriterien:
- Geschäftskritikalität: Welche Prozesse stehen still, wenn die Anwendung nicht mehr erreichbar ist? Hier sollte untersucht werden, welche unmittelbaren Auswirkungen ein Ausfall auf Umsatz, Kundenbeziehungen, Lieferfähigkeit und interne Abläufe hat. Dabei ist auch zu berücksichtigen, ob gesetzliche oder vertragliche Verpflichtungen betroffen sind. Eine Anwendung kann technisch unspektakulär erscheinen und trotzdem für einen zentralen Geschäftsprozess unverzichtbar sein. Die Bewertung sollte deshalb gemeinsam mit den jeweiligen Fachbereichsverantwortlichen erfolgen.
- Datenkritikalität: Welche Informationen liegen im System und wie schnell lassen sie sich wiederherstellen? Kundendaten, Vertragsinformationen, Projektwissen und Finanzdaten besitzen einen völlig anderen Stellenwert als temporäre Arbeitsinformationen. Zusätzlich muss geprüft werden, ob die Daten auch außerhalb der SaaS-Plattform vollständig verfügbar sind. Besonders kritisch sind Systeme, in denen über Jahre gewachsenes Unternehmenswissen gespeichert wird. Ein verlorener Datensatz lässt sich möglicherweise ersetzen, jahrelang aufgebautes Wissen hingegen nicht immer.
- Technische Abhängigkeit: Welche Schnittstellen, Automatisierungen und weiteren Anwendungen sind mit dem Dienst verbunden? Je stärker ein System in die bestehende IT-Architektur integriert ist, desto aufwendiger wird ein Wechsel. Proprietäre APIs, individuelle Erweiterungen und nicht dokumentierte Schnittstellen können eine Migration erheblich erschweren. Auch Single Sign-on, Benutzerverwaltung und Berechtigungskonzepte müssen berücksichtigt werden. Die Abhängigkeit endet schließlich nicht bei der eigentlichen Anwendung.
- Anbieterabhängigkeit: Wie stark ist das Unternehmen von der wirtschaftlichen und strategischen Stabilität des Anbieters abhängig? Hier spielen Unternehmensgröße, Eigentümerstruktur, Finanzlage, Produktstrategie und Supportqualität eine Rolle. Ein kleiner Spezialanbieter kann eine hervorragende Lösung liefern, gleichzeitig aber ein höheres Ausfallrisiko besitzen als ein etablierter Marktteilnehmer. Das bedeutet nicht, dass kleine Anbieter grundsätzlich ungeeignet sind. Entscheidend ist, ob das Unternehmen auf einen möglichen Wegfall vorbereitet ist.
Das Ergebnis sollte ein zentrales SaaS-Register sein, das Verantwortlichkeiten, Vertragslaufzeiten, Datenbestände, Schnittstellen, Abhängigkeiten und Kritikalität dokumentiert. Dieses Register muss regelmäßig aktualisiert werden, denn eine einmalige Inventarisierung verliert schnell ihren Wert.
Vertragsgestaltung, SLAs und Software Escrow – Sicherheit auf dem Papier?
Ein weiterer zentraler Baustein ist die vertragliche Absicherung. Viele Unternehmen konzentrieren sich bei der Beschaffung auf Funktionsumfang, Lizenzkosten und Verfügbarkeit. Die Frage, was bei einer dauerhaften Einstellung des Dienstes passiert, wird dagegen häufig nur am Rande behandelt. Genau das ist ein Fehler, denn ein SLA mit 99,9 Prozent Verfügbarkeit hilft wenig, wenn der Anbieter seine Geschäftstätigkeit vollständig einstellt.
Verträge sollten deshalb klare Regelungen zur Datenherausgabe, zu Exportformaten, Kündigungsrechten, Übergangsfristen und Unterstützungsleistungen bei einer Migration enthalten. Besonders relevant sind außerdem Regelungen für den Fall einer Insolvenz oder eines Eigentümerwechsels. Dabei sollte geprüft werden, welche Rechte das Unternehmen tatsächlich besitzt und welche Leistungen der Anbieter im Rahmen eines Exit-Szenarios noch erbringen muss.
Eine interessante Möglichkeit ist Software Escrow. Dabei werden Quellcode, technische Dokumentationen und gegebenenfalls weitere für den Betrieb erforderliche Bestandteile bei einem unabhängigen Treuhänder hinterlegt. Unter vertraglich definierten Voraussetzungen, beispielsweise bei einer Insolvenz oder der dauerhaften Einstellung des Supports, kann der hinterlegte Bestand freigegeben werden.
Allerdings gibt es einen entscheidenden Unterschied zwischen klassischem Software Escrow und einem echten SaaS-Continuity-Konzept. Bei einer SaaS-Anwendung reicht der Quellcode allein häufig nicht aus. Zusätzlich werden Infrastrukturdefinitionen, Datenbankstrukturen, Konfigurationen, Build-Prozesse, Deployment-Skripte, Zertifikate und gegebenenfalls Zugangsdaten benötigt. Auch Drittanbieterkomponenten und externe Abhängigkeiten müssen berücksichtigt werden. Eine Quellcode-Hinterlegung ohne realistische Möglichkeit, die Anwendung wieder aufzubauen, vermittelt daher möglicherweise mehr Sicherheit, als tatsächlich vorhanden ist.
Bei kritischen Anwendungen sollte deshalb geprüft werden, ob eine vollständige technische Wiederherstellbarkeit vertraglich und praktisch gewährleistet werden kann.
Datenhoheit und Portabilität – Dein Datenbestand gehört nicht in eine digitale Sackgasse
Die wichtigste präventive Maßnahme bleibt jedoch die Kontrolle über die eigenen Daten. Unternehmen sollten sich niemals ausschließlich darauf verlassen, dass ein Anbieter im Notfall noch einen vollständigen Export ermöglicht. Stattdessen müssen regelmäßige, automatisierte Datensicherungen und unabhängige Exportmöglichkeiten etabliert werden.
Dabei reicht es nicht, gelegentlich eine CSV-Datei herunterzuladen. Ein CRM-Export ohne Beziehungen zwischen Kunden, Kontakten, Aktivitäten und Dokumenten ist beispielsweise nur bedingt hilfreich. Auch Metadaten, Berechtigungen, Versionshistorien und Anhänge können für eine erfolgreiche Migration entscheidend sein.
Sinnvoll sind standardisierte Exportformate wie CSV, JSON oder XML, sofern diese die tatsächlichen Datenstrukturen vollständig abbilden. Bei komplexeren Anwendungen können API-basierte Exporte notwendig sein. Entscheidend ist, dass die exportierten Daten außerhalb der ursprünglichen SaaS-Plattform gespeichert und regelmäßig auf Vollständigkeit geprüft werden.
Zusätzlich sollten Wiederherstellungstests durchgeführt werden. Ein Backup, das sich im Ernstfall nicht importieren lässt, ist letztlich nur ein digitales Beruhigungsmittel. Die Fähigkeit, Daten unabhängig vom ursprünglichen Anbieter wiederherzustellen, ist ein wesentlicher Bestandteil echter digitaler Souveränität.
Phase 2 – Der Notfallplan: Business Continuity statt hektischer Krisensitzungen
Prävention reduziert Risiken, beseitigt sie aber nicht vollständig. Deshalb benötigt jedes Unternehmen mit geschäftskritischen SaaS-Abhängigkeiten einen konkreten Notfallplan. Dieser sollte Bestandteil des übergeordneten Business Continuity Managements (BCM) sein und nicht als isoliertes IT-Dokument in irgendeinem Verzeichnis verschwinden.
Ein guter Notfallplan beantwortet drei zentrale Fragen: Wann wird eine Krise ausgerufen? Wer entscheidet über die notwendigen Maßnahmen? Und wie wird der Geschäftsbetrieb aufrechterhalten, wenn eine zentrale Anwendung nicht mehr verfügbar ist? Diese Fragen müssen vor dem Ernstfall geklärt sein. Denn wenn ein Anbieter am Freitagabend seine Plattform abschaltet, ist es definitiv der falsche Zeitpunkt, erst einmal herauszufinden, wer eigentlich die Verantwortung trägt.
Die Planung sollte außerdem regelmäßig getestet werden. Eine Exit-Strategie, die nur auf dem Papier existiert, besitzt keinen praktischen Beweis ihrer Funktionsfähigkeit. Unternehmen sollten deshalb realistische Ausfallszenarien durchspielen und überprüfen, ob die definierten Maßnahmen tatsächlich innerhalb der vorgesehenen Zeit umgesetzt werden können.
Frühwarnsysteme – Die Signale erkennen, bevor das Licht ausgeht
Nicht jede Anbieterkrise kommt überraschend. Häufig gibt es bereits Wochen oder Monate vorher Anzeichen dafür, dass sich die Situation verschlechtert. Diese Hinweise müssen nicht zwangsläufig eine Insolvenz ankündigen, können aber Anlass für eine erneute Risikobewertung sein.
Besonders relevant sind folgende Indikatoren:
- Ungewöhnliche Personalbewegungen: Wenn wichtige Entwickler, Produktverantwortliche oder Führungskräfte das Unternehmen verlassen, kann das auf interne Probleme hindeuten. Besonders kritisch wird es, wenn gleichzeitig Support- und Entwicklungsbereiche ausgedünnt werden. Unternehmen sollten Veränderungen bei ihren strategischen SaaS-Partnern deshalb aufmerksam verfolgen. Einzelne Kündigungen sind noch kein Krisensignal, eine Häufung wichtiger Abgänge dagegen schon eher. Entscheidend ist die Entwicklung über einen längeren Zeitraum.
- Nachlassende Produktentwicklung: Werden angekündigte Funktionen wiederholt verschoben, verschwinden Roadmap-Einträge oder bleiben Sicherheitsupdates aus, sollte man genauer hinschauen. Ein Produkt, das technisch nicht mehr weiterentwickelt wird, kann langfristig zum Sicherheits- und Betriebsrisiko werden. Auch eine auffällige Häufung ungelöster Fehler ist ein möglicher Indikator. Unternehmen sollten regelmäßig prüfen, ob die tatsächliche Produktentwicklung noch zur eigenen IT-Strategie passt. Eine eingefrorene Roadmap ist kein gutes Fundament für langfristige Abhängigkeiten.
- Verschlechterter Support: Lange Reaktionszeiten, wechselnde Ansprechpartner und unbeantwortete kritische Tickets können auf organisatorische oder wirtschaftliche Schwierigkeiten hinweisen. Besonders problematisch ist es, wenn vertraglich zugesicherte Supportleistungen nicht mehr erbracht werden. Der Support ist häufig einer der ersten Bereiche, in denen sich interne Probleme bemerkbar machen. Unternehmen sollten SLA-Verletzungen dokumentieren und bei wiederholten Auffälligkeiten eskalieren. Ein funktionierender Eskalationsprozess kann wertvolle Zeit verschaffen.
- Abrupte Preis- und Produktänderungen: Massive Preiserhöhungen, die Einstellung wichtiger Funktionen oder die erzwungene Umstellung auf neue Tarifmodelle können auf eine strategische Neuausrichtung hindeuten. Das muss nicht unmittelbar eine Insolvenz bedeuten, kann aber die wirtschaftliche Grundlage der bisherigen Lösung zerstören. Gerade bei stark integrierten Systemen entstehen dadurch erhebliche Wechselkosten. Deshalb sollten Preisänderungen immer im Zusammenhang mit der eigenen Anbieterabhängigkeit bewertet werden. Wer erst bei der nächsten Rechnung reagiert, hat möglicherweise bereits wertvolle Handlungszeit verloren.
Diese Frühwarnindikatoren sollten in ein regelmäßiges Lieferanten- und Risikomanagement einfließen. Bei besonders kritischen Anwendungen empfiehlt sich eine quartalsweise Überprüfung.
RTO und RPO – Zwei Kennzahlen, die im Ernstfall über den Schaden entscheiden
Ein professioneller Notfallplan benötigt messbare Wiederherstellungsziele. Hier kommen zwei zentrale Kennzahlen aus dem Business Continuity Management ins Spiel: Recovery Time Objective (RTO) und Recovery Point Objective (RPO).
Das RTO beschreibt die maximal akzeptable Zeit, bis ein Geschäftsprozess oder IT-System nach einem Ausfall wieder verfügbar sein muss. Das RPO beschreibt den maximal tolerierbaren Datenverlust beziehungsweise den Zeitpunkt, auf den Daten wiederhergestellt werden müssen.
Ein Beispiel: Ein Unternehmen nutzt ein SaaS-System zur Auftragsverwaltung. Fällt dieses System aus, muss innerhalb von acht Stunden eine alternative Arbeitsmöglichkeit bereitstehen. Das RTO beträgt damit acht Stunden. Werden die Auftragsdaten alle zwei Stunden unabhängig gesichert, liegt das angestrebte RPO bei zwei Stunden. Im ungünstigsten Fall können also die letzten zwei Stunden an Daten verloren gehen.
Wichtig ist, dass diese Werte nicht willkürlich festgelegt werden. Sie müssen aus einer Business Impact Analysis (BIA) abgeleitet werden. Dabei wird untersucht, welche wirtschaftlichen, rechtlichen und operativen Folgen ein Ausfall nach einer bestimmten Zeit verursacht.
Eine Anwendung mit geringer Geschäftskritikalität kann möglicherweise mehrere Tage ausfallen. Bei einem zentralen ERP-, Produktions- oder Zahlungssystem kann bereits eine Stunde erhebliche Schäden verursachen. Entsprechend unterschiedlich müssen die Wiederherstellungsstrategien aussehen.
Rollen und Verantwortlichkeiten – Wer übernimmt das Steuer?
Im Krisenfall benötigt das Unternehmen eine klare Führungsstruktur. Die Verantwortung darf nicht ausschließlich bei der IT liegen, denn ein SaaS-Ausfall kann weitreichende Auswirkungen auf Kunden, Lieferanten, Finanzen und Geschäftsprozesse haben.
Der Krisenstab sollte deshalb interdisziplinär aufgestellt sein. Die Geschäftsführung übernimmt die strategische Entscheidungsverantwortung, während IT und Informationssicherheit die technische Bewertung und Umsetzung koordinieren. Fachbereiche liefern Informationen zu den betroffenen Geschäftsprozessen, und die Rechtsabteilung prüft vertragliche sowie rechtliche Fragestellungen.
Ebenso wichtig ist eine eindeutige Kommunikationsverantwortung. Wer informiert Mitarbeiter? Wer spricht mit Kunden? Wer kommuniziert mit dem Anbieter oder einem Insolvenzverwalter? Ohne klare Zuständigkeiten entstehen schnell widersprüchliche Informationen und unnötige Verzögerungen.
Alle relevanten Ansprechpartner sollten inklusive Stellvertretungen und Kontaktdaten in einem außerhalb der betroffenen SaaS-Plattform verfügbaren Notfallhandbuch dokumentiert sein. Denn auch das wäre ein Klassiker: Das Notfallhandbuch liegt ausgerechnet in dem Cloud-System, das gerade ausgefallen ist.
Phase 3 – Operatives Krisenmanagement: Wenn der Anbieter tatsächlich verschwindet
Jetzt wird aus der theoretischen Planung Realität. Der Anbieter meldet Insolvenz an, kündigt die Einstellung seines Dienstes an oder die Plattform ist plötzlich nicht mehr erreichbar. In dieser Situation zählt jede Stunde.
Die wichtigste Regel lautet: Zunächst den Schaden begrenzen und die eigene Handlungsfähigkeit sichern. Unternehmen sollten nicht sofort mit einer unkoordinierten Migration beginnen. Zuerst müssen Datenbestände gesichert, Zugriffsrechte geprüft, Abhängigkeiten bewertet und die Auswirkungen auf laufende Geschäftsprozesse festgestellt werden.
Besonders kritisch ist die Kommunikation mit dem Anbieter. Solange noch Ansprechpartner erreichbar sind, sollten Unternehmen sämtliche Möglichkeiten nutzen, um vollständige Datenexporte, technische Dokumentationen und gegebenenfalls Übergangsleistungen zu erhalten. Gleichzeitig müssen alle relevanten Informationen unabhängig dokumentiert werden. Auf mündliche Zusagen sollte man sich in einer solchen Situation keinesfalls verlassen.
Sofortmaßnahmen bei Insolvenz oder plötzlicher Abschaltung
Die ersten Maßnahmen sollten einem festgelegten Ablauf folgen:
- Datenbestand sichern: Bestehende Datenexporte, Backups und verfügbare API-Schnittstellen müssen unverzüglich geprüft und genutzt werden. Dabei sollte der aktuelle Datenstand möglichst unverändert archiviert werden. Wichtig sind auch Metadaten, Anhänge, Protokolle und Informationen zu Benutzerrechten. Jede zusätzliche Veränderung kann die spätere Migration erschweren. Die Sicherung sollte nachvollziehbar dokumentiert und auf Integrität geprüft werden.
- Zugänge und Berechtigungen kontrollieren: Unternehmen müssen feststellen, welche administrativen Zugänge noch funktionieren und welche externen Konten betroffen sind. Gleichzeitig sollten kritische Zugangsdaten, API-Schlüssel und Integrationen überprüft werden. Bestehende Zugänge dürfen nicht unkontrolliert verändert oder gelöscht werden, solange sie für die Datensicherung benötigt werden. Nach der Sicherung müssen nicht mehr benötigte Berechtigungen kontrolliert entzogen werden. Besonders bei Sicherheitsvorfällen ist eine koordinierte Zugangssperre unverzichtbar.
- Rechtliche Situation prüfen: Bei einer Insolvenz sollte die Rechtsabteilung frühzeitig eingebunden werden. Zu prüfen sind unter anderem Kündigungsrechte, vertragliche Herausgabeansprüche, Datenschutzpflichten und die Kommunikation mit dem Insolvenzverwalter. Wichtig ist auch die Frage, ob personenbezogene Daten weiterhin rechtmäßig verarbeitet werden können. Ein Insolvenzverfahren bedeutet nicht automatisch, dass sämtliche Verträge sofort enden oder Daten unmittelbar gelöscht werden. Die konkrete rechtliche Situation muss deshalb individuell bewertet werden.
- Krisenkommunikation aktivieren: Mitarbeiter, Kunden und gegebenenfalls Geschäftspartner müssen abhängig von den Auswirkungen informiert werden. Dabei sollten klare Aussagen über die aktuelle Situation, verfügbare Alternativen und mögliche Einschränkungen getroffen werden. Unbestätigte Informationen und Spekulationen sind zu vermeiden. Besonders bei kundenrelevanten Systemen ist eine transparente Kommunikation entscheidend. Die Kommunikationsmaßnahmen müssen zentral koordiniert werden.
Brückenlösungen – Manchmal ist Excel der Held des Tages
Nicht jeder Systemausfall lässt sich innerhalb weniger Stunden durch eine neue Plattform ersetzen. Gerade komplexe SaaS-Anwendungen benötigen Zeit für Datenmigration, Konfiguration, Schnittstellenanpassungen und Tests. Deshalb sind temporäre Brückenlösungen ein wichtiger Bestandteil jeder Exit-Strategie.
Je nach Anwendung können bestehende Legacy-Systeme reaktiviert, lokale Datenbestände genutzt oder manuelle Prozesse eingeführt werden. Bei einer ausgefallenen Projektmanagementplattform kann beispielsweise eine vorbereitete Tabellenlösung die wichtigsten Aufgaben, Verantwortlichkeiten und Termine abbilden. Bei einem CRM-Ausfall können gesicherte Kundendaten vorübergehend in einer alternativen Datenbank bereitgestellt werden.
Solche Workarounds sind natürlich keine dauerhafte Lösung. Sie müssen klare Verantwortlichkeiten, Zugriffsbeschränkungen und Dokumentationspflichten besitzen. Besonders wichtig ist die spätere Überführung aller während der Übergangszeit entstandenen Informationen in das neue System. Sonst entsteht nach der Migration ein zweites Problem: Die Daten sind zwar wieder verfügbar, aber niemand weiß mehr, welche Informationen aktuell sind.
Ein gut vorbereiteter Notfallplan definiert deshalb bereits im Vorfeld, welche Prozesse notfalls manuell oder mit vereinfachten Werkzeugen weitergeführt werden können. Das spart im Ernstfall nicht nur Zeit, sondern reduziert auch die Gefahr unkontrollierter Schatten-IT.
Phase 4 – Migration und Neuorientierung: Aus der Krise eine bessere IT-Architektur machen
Sobald der unmittelbare Geschäftsbetrieb abgesichert ist, beginnt die eigentliche Neuorientierung. Jetzt muss entschieden werden, welche Plattform künftig die Aufgaben des ausgefallenen SaaS-Dienstes übernimmt. Dabei wäre es ein Fehler, einfach den erstbesten verfügbaren Ersatz zu wählen.
Eine Krise bietet auch die Gelegenheit, die bisherige Architektur kritisch zu hinterfragen. Wurde die ursprüngliche Lösung vielleicht über die Jahre mit zahlreichen Zusatzfunktionen und individuellen Erweiterungen überladen? Gibt es Funktionen, die kaum jemand nutzt? Sind Geschäftsprozesse unnötig stark an einen bestimmten Anbieter gekoppelt?
Die Migration sollte deshalb nicht ausschließlich als technischer Austausch verstanden werden. Sie ist gleichzeitig eine Chance, Prozesse zu vereinfachen, Abhängigkeiten zu reduzieren und die digitale Souveränität des Unternehmens zu stärken.
Open Source, Self-Hosting oder der nächste SaaS-Anbieter?
Bei der Auswahl einer Alternative stehen grundsätzlich mehrere Möglichkeiten zur Verfügung. Ein erneuter Wechsel zu einem anderen SaaS-Anbieter ist häufig der schnellste Weg. Bestehende Prozesse können teilweise übernommen werden, und der operative Betrieb bleibt weiterhin beim Dienstleister.
Allerdings entsteht dadurch nicht automatisch eine bessere Exit-Situation. Wer lediglich von Anbieter A zu Anbieter B wechselt, ohne Datenportabilität und Wechselmöglichkeiten zu verbessern, wiederholt möglicherweise denselben strategischen Fehler. Deshalb müssen offene Schnittstellen, Exportmöglichkeiten und standardisierte Datenformate von Anfang an Bewertungskriterien sein.
Eine interessante Alternative sind Open-Source-Lösungen mit eigenem Hosting. Plattformen wie Nextcloud, OpenProject oder andere selbst betriebene Anwendungen ermöglichen mehr Kontrolle über Infrastruktur, Daten und Updatezyklen. Unternehmen können selbst entscheiden, wo ihre Daten gespeichert werden und welche technischen Anpassungen vorgenommen werden.
Allerdings sollte man auch hier nicht in die nächste romantische Fehlannahme verfallen: Open Source bedeutet nicht automatisch Unabhängigkeit. Ohne qualifiziertes Personal, Sicherheitsupdates, Backup-Konzepte und professionellen Betrieb kann eine selbst gehostete Lösung schnell zum nächsten Problem werden. Die tatsächliche Unabhängigkeit entsteht erst durch die Kombination aus offenen Technologien, beherrschbarer Architektur und eigener Betriebsfähigkeit.
Die Entscheidung sollte deshalb anhand folgender Kriterien getroffen werden:
- SaaS-Wechsel: Geeignet, wenn eine schnelle Wiederherstellung benötigt wird und ein alternativer Anbieter vergleichbare Funktionen bereitstellt. Der administrative Aufwand bleibt überschaubar, da Infrastruktur und Wartung weiterhin extern verantwortet werden. Allerdings müssen Datenmigration, Schnittstellen und Vertragsbedingungen sorgfältig geprüft werden. Auch die wirtschaftliche Stabilität des neuen Anbieters gehört auf den Prüfstand. Ein Anbieterwechsel ohne verbesserte Exit-Regelungen wäre lediglich ein Austausch der Abhängigkeit.
- Open-Source-Self-Hosting: Besonders interessant, wenn Datenhoheit, Anpassbarkeit und langfristige Kontrolle im Vordergrund stehen. Unternehmen können ihre Systeme in einer eigenen Infrastruktur oder einer Private Cloud betreiben. Dafür benötigen sie entsprechende technische Kompetenzen und klare Betriebsverantwortlichkeiten. Auch Wartung, Updates, Monitoring und Sicherheitsmaßnahmen müssen dauerhaft gewährleistet sein. Der Lizenzpreis ist dabei nur ein kleiner Teil der tatsächlichen Betriebskosten.
- Hybride Architektur: Eine Kombination aus externen SaaS-Diensten und selbst kontrollierten Kernkomponenten kann einen sinnvollen Mittelweg darstellen. Besonders kritische Datenbestände und Integrationen lassen sich unabhängig vom jeweiligen Anbieter absichern. Dadurch sinkt das Risiko, dass der Ausfall eines einzelnen Dienstes die gesamte IT-Landschaft lahmlegt. Gleichzeitig bleiben die Vorteile externer Plattformen erhalten. Voraussetzung ist allerdings eine sauber dokumentierte und beherrschbare Architektur.
Der Migrations-Fahrplan – Nicht einfach Daten von A nach B schieben
Eine erfolgreiche Migration benötigt einen strukturierten Ablauf. Der erste Schritt ist die Analyse und Bereinigung der vorhandenen Daten. Doppelte Datensätze, veraltete Informationen und nicht mehr benötigte Benutzerkonten sollten identifiziert werden. Anschließend müssen Datenstrukturen und Feldzuordnungen zwischen altem und neuem System definiert werden.
Im nächsten Schritt erfolgt der eigentliche Import. Dabei sollten zunächst Testmigrationen mit repräsentativen Datenbeständen durchgeführt werden. Besonders wichtig sind die Beziehungen zwischen Datensätzen, Berechtigungen, Dokumenten und historischen Informationen. Eine Migration, bei der lediglich die Anzahl der importierten Datensätze stimmt, ist noch lange kein Erfolg.
Nach dem Import müssen umfangreiche Funktionstests folgen. Dazu gehören die Überprüfung zentraler Geschäftsprozesse, Schnittstellen, Benutzerrechte und Automatisierungen. Erst wenn die wichtigsten Abläufe zuverlässig funktionieren, sollte das neue System produktiv eingesetzt werden.
Auch die Mitarbeiter dürfen nicht vergessen werden. Neue Oberflächen, geänderte Arbeitsabläufe und möglicherweise entfallene Funktionen erfordern eine gezielte Schulung. Eine technisch erfolgreiche Migration kann operativ trotzdem scheitern, wenn die Anwender nicht wissen, wie sie mit dem neuen System arbeiten sollen.
Post-Mortem-Analyse – Was wir aus dem Ausfall lernen müssen
Nach erfolgreicher Wiederherstellung sollte eine strukturierte Nachbetrachtung stattfinden. Dabei geht es ausdrücklich nicht darum, Schuldige zu suchen. Vielmehr muss untersucht werden, welche Faktoren zum Ausfall geführt haben und warum bestimmte Abhängigkeiten möglicherweise nicht rechtzeitig erkannt wurden.
Waren die vertraglichen Regelungen ausreichend? Haben die vorhandenen Backups funktioniert? Wurden die definierten RTO- und RPO-Werte eingehalten? Wie schnell konnte der Krisenstab reagieren? Und welche Geschäftsprozesse waren stärker betroffen als ursprünglich angenommen?
Die Erkenntnisse müssen anschließend in konkrete Verbesserungsmaßnahmen überführt werden. Dazu gehören möglicherweise neue Vertragsstandards, regelmäßige Exit-Tests, zusätzliche Datenexporte oder eine veränderte Cloud-Architektur.
Besonders wichtig ist, dass diese Erkenntnisse nicht in einem Abschlussbericht verschwinden. Die Verantwortung für die Umsetzung muss klar zugeordnet und deren Fortschritt überprüft werden. Andernfalls war die gesamte Krise zwar teuer, aber zumindest strategisch vollkommen nutzlos.
Fazit – Eine SaaS-Exit-Strategie ist kein Pessimismus, sondern unternehmerische Vernunft
Cloud-Dienste sind aus modernen Unternehmen kaum noch wegzudenken. Sie ermöglichen Geschwindigkeit, Skalierbarkeit und einen flexiblen Zugriff auf leistungsfähige Technologien. Doch mit jeder ausgelagerten Anwendung wächst auch die Abhängigkeit von externen Anbietern. Wer diese Abhängigkeiten nicht kennt und kontrolliert, riskiert im Ernstfall erhebliche operative und wirtschaftliche Schäden.
Eine SaaS-Exit-Strategie bedeutet deshalb nicht, dass Unternehmen ihre gesamte IT wieder selbst betreiben müssen. Es geht vielmehr darum, jederzeit handlungsfähig zu bleiben. Daten müssen unabhängig verfügbar sein, kritische Geschäftsprozesse benötigen alternative Betriebswege und Verträge müssen realistische Ausstiegsmöglichkeiten vorsehen.
Besonders wichtig ist ein Perspektivwechsel im IT-Management: Die Frage darf nicht nur lauten, ob ein SaaS-Anbieter heute die beste Lösung liefert. Sie muss auch lauten, wie schnell und mit welchem Aufwand das Unternehmen diese Lösung morgen verlassen könnte.
Der europäische Data Act setzt hier zusätzliche Impulse. Seit dem 12. September 2025 gelten die Regelungen zum Anbieterwechsel für Datenverarbeitungsdienste. Sie sollen Wechselbarrieren reduzieren und die Portabilität verbessern. Ab dem 12. Januar 2027 dürfen für entsprechende Anbieterwechsel grundsätzlich keine Wechselentgelte mehr erhoben werden. Das ist ein wichtiger Schritt, ersetzt aber keine eigene technische und organisatorische Vorsorge.
Denn eines sollte jedem Geschäftsführer und IT-Entscheider bewusst sein: Die Kontrolle über die eigene digitale Handlungsfähigkeit darf niemals vollständig von der Zukunft eines externen Unternehmens abhängen.
Wer heute seine Exit-Strategie entwickelt, muss morgen nicht in Panik verfallen. Und wer seine Abhängigkeiten kennt, kann Cloud-Technologien weiterhin nutzen, ohne sich ihnen blind auszuliefern.
Die 5-Punkte-Checkliste für jedes IT-Management
Du möchtest direkt anfangen? Dann sollten diese fünf Maßnahmen auf deiner Agenda stehen:
- SaaS-Bestand erfassen und bewerten: Dokumentiere sämtliche eingesetzten Cloud-Anwendungen, ihre Geschäftsprozessabhängigkeiten und die jeweiligen Verantwortlichkeiten. Identifiziere besonders kritische Systeme und priorisiere diese nach ihrem tatsächlichen Ausfallrisiko. Berücksichtige auch Schatten-IT und Anwendungen, die außerhalb der zentralen IT-Beschaffung eingeführt wurden. Ohne vollständige Transparenz ist kein vernünftiges Risikomanagement möglich.
- Daten unabhängig sichern: Stelle sicher, dass kritische Daten regelmäßig außerhalb der jeweiligen SaaS-Plattform gespeichert werden. Nutze standardisierte Exportformate und dokumentiere die notwendigen Import- und Wiederherstellungsprozesse. Prüfe regelmäßig, ob sich die gesicherten Daten tatsächlich wiederherstellen lassen. Ein Backup ohne erfolgreichen Restore-Test ist keine belastbare Absicherung.
- Verträge und Exit-Klauseln überprüfen: Kontrolliere SLAs, Kündigungsfristen, Datenherausgabe, Exportmöglichkeiten und Regelungen für eine dauerhafte Betriebseinstellung. Prüfe bei besonders kritischen Anwendungen, ob Software Escrow oder weitergehende SaaS-Continuity-Vereinbarungen sinnvoll sind. Beziehe dabei auch technische Abhängigkeiten und notwendige Drittanbieterkomponenten ein. Rechtliche Zusicherungen müssen immer mit der tatsächlichen technischen Wiederherstellbarkeit zusammenpassen.
- RTO, RPO und Notfallverantwortlichkeiten definieren: Lege fest, wie lange kritische Prozesse ausfallen dürfen und welcher Datenverlust maximal akzeptabel ist. Bestimme einen Krisenstab mit klaren Entscheidungsbefugnissen und Stellvertretungen. Dokumentiere konkrete Sofortmaßnahmen und alternative Betriebswege. Sorge dafür, dass alle relevanten Informationen auch bei einem vollständigen Cloud-Ausfall verfügbar bleiben.
- Exit-Szenarien regelmäßig testen: Simuliere mindestens für besonders kritische Anwendungen einen vollständigen Anbieterwechsel. Prüfe, ob Datenexporte funktionieren, Alternativsysteme verfügbar sind und die Migration innerhalb der geplanten Zeit durchgeführt werden kann. Dokumentiere Schwachstellen und leite konkrete Verbesserungsmaßnahmen ab. Nur ein erfolgreich getesteter Exit-Plan ist ein belastbarer Nachweis tatsächlicher Handlungsfähigkeit.
Mein abschließender Gedanke: Es ist durchaus sinnvoll, auf die Expertise spezialisierter Cloud-Anbieter zu setzen. Es ist aber nicht sinnvoll, die eigene Zukunftsfähigkeit gleich mit auszulagern. Ein guter SaaS-Anbieter macht dich produktiver. Eine gute Exit-Strategie sorgt dafür, dass du auch ohne ihn produktiv bleiben kannst. Ich selbst kenne nicht viele Unternehmen, die für ihre aktiv in Nutzung befindlichen SaaS-Anwendungen eine Exit-Strategie in der Schublade liegen haben.
Leserfrage:
Was wäre in deinem Unternehmen der kritischste SaaS-Ausfall? Könntet ihr innerhalb von 24 Stunden auf eine Alternative wechseln oder würde ein solcher Vorfall erst einmal den Geschäftsbetrieb lahmlegen?