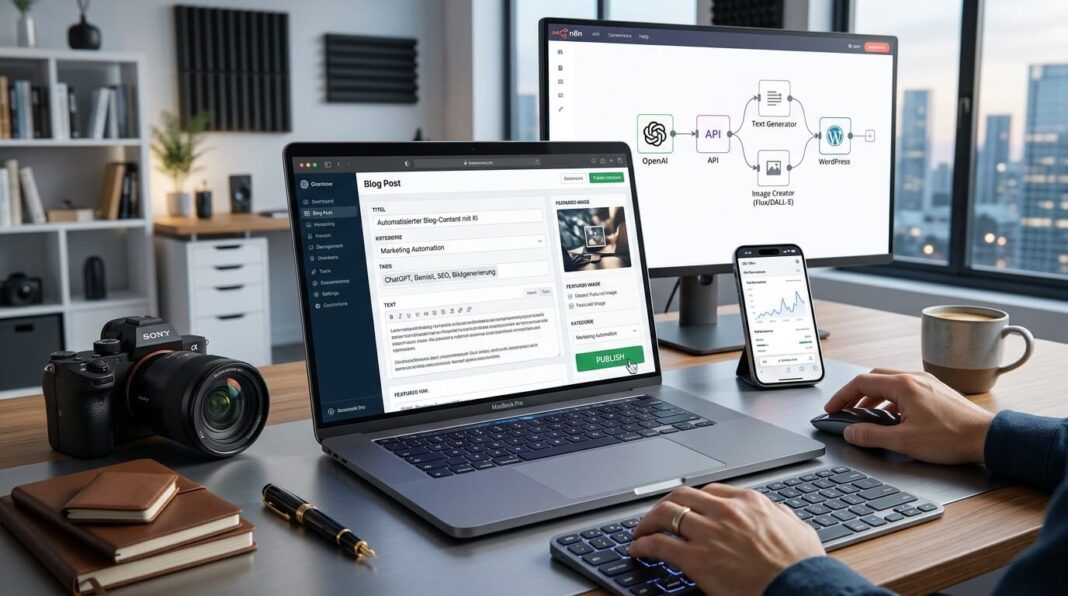

Stell dir vor, du hast eine gute Idee für einen Blogartikel. Du trägst ein Keyword in eine Tabelle ein, klickst auf einen Button und gehst anschließend einen Kaffee trinken. Währenddessen analysiert eine KI das Thema, erstellt eine Artikelstruktur, recherchiert relevante Inhalte, schreibt einen ausführlichen Beitrag, entwickelt ein passendes Titelbild, generiert SEO-Metadaten und überträgt alles sauber formatiert in dein WordPress-System. Wenn du zurückkommst, wartet dort bereits ein nahezu fertiger Artikel auf deine redaktionelle Freigabe. Was früher mehrere Stunden manueller Arbeit bedeutet hat, läuft inzwischen weitgehend automatisiert im Hintergrund. Willkommen in der Welt intelligenter Content-Pipelines!
Schluss mit Copy & Paste – willkommen in der automatisierten Content-Produktion!
Der Paradigmenwechsel liegt dabei nicht einfach darin, dass eine KI Texte schreiben kann. Das können mittlerweile viele Werkzeuge ziemlich ordentlich. Die eigentliche Veränderung entsteht durch die intelligente Verkettung einzelner Arbeitsschritte zu einem durchgängigen Prozess. Aus isolierten Werkzeugen wird ein zusammenhängendes System, in dem Daten strukturiert übergeben, Ergebnisse überprüft und Folgeprozesse automatisch angestoßen werden. Genau hier beginnt die eigentliche Automatisierung: Nicht die KI allein produziert Content, sondern eine orchestrierte Prozesslandschaft übernimmt die gesamte Produktionskette. Das Ergebnis ist eine skalierbare Content-Produktion, die sich auch für kleinere Unternehmen, Einzelunternehmer und ambitionierte Blogger wirtschaftlich betreiben lässt.
Das Ziel dieses Artikels ist deshalb ein konkreter Praxisansatz: Wir bauen einen Workflow, bei dem beispielsweise ein neues Keyword aus einer Datenquelle den Produktionsprozess auslöst. Am Ende entsteht ein fertig formulierter, bebilderter, kategorisierter und SEO-optimierter Entwurf in WordPress. Dabei behalten wir einen entscheidenden Grundsatz im Blick: Automatisierung darf niemals mit blindem Vertrauen verwechselt werden. Ein guter Workflow automatisiert Routine, nicht Verantwortung.
Die Systemarchitektur: Welche Werkzeuge brauchen wir?
Bevor wir den ersten Workflow bauen, sollten wir verstehen, welche Komponenten zusammenspielen müssen. Eine automatisierte Content-Pipeline besteht aus mehreren spezialisierten Systemen, die über Schnittstellen miteinander kommunizieren. Das Herzstück bildet eine Orchestrierungsplattform, die Aufgaben verteilt, Daten weiterreicht und Fehler behandelt. Hinzu kommen KI-Dienste für Text und Bild, eine Datenquelle für den redaktionellen Input und schließlich das Content-Management-System als Zielplattform. Wer diese Architektur sauber aufsetzt, kann später einzelne Komponenten austauschen, ohne den gesamten Prozess neu entwickeln zu müssen.
Für die Orchestrierung stehen insbesondere drei Ansätze zur Verfügung:
- n8n: Die Open-Source-orientierte Workflow-Automatisierungsplattform lässt sich selbst hosten oder als Cloud-Dienst betreiben. Besonders interessant sind die umfangreichen Integrationsmöglichkeiten, HTTP-Requests, eigene JavaScript-Funktionen und die Unterstützung KI-gestützter Prozesse. Durch Self-Hosting lassen sich Datenflüsse und Infrastruktur stärker kontrollieren. Allerdings bedeutet Self-Hosting auch Verantwortung für Updates, Backups, Zugriffsschutz und Monitoring. Für datenschutzbewusste Unternehmen ist n8n deshalb eine ausgesprochen interessante Option.
- Make.com: Die Plattform setzt auf eine visuelle Workflow-Entwicklung und ermöglicht es, komplexe Automatisierungen vergleichsweise schnell zusammenzustellen. Gerade Einsteiger profitieren von der grafischen Darstellung einzelner Module und Datenübergaben. Die Bedienung ist komfortabel, allerdings sollte man bei umfangreichen Szenarien die Kosten pro Operation und die Abhängigkeit vom Cloud-Anbieter berücksichtigen. Auch die Verarbeitung personenbezogener oder vertraulicher Daten muss datenschutzrechtlich bewertet werden. Für viele kleinere Content-Workflows ist Make dennoch ein schneller Einstieg.
- Python-Skripte: Wer maximale technische Kontrolle benötigt, kann die gesamte Pipeline selbst programmieren. Python eignet sich hervorragend für API-Kommunikation, Datenvalidierung, Bildverarbeitung und individuelle Geschäftslogik. Der Nachteil liegt im höheren Entwicklungs- und Wartungsaufwand. Fehlerbehandlung, Protokollierung und Zeitsteuerung müssen selbst implementiert werden. Dafür entstehen kaum Grenzen hinsichtlich der möglichen Prozessgestaltung.
Für die Textgenerierung kommen beispielsweise die OpenAI API und die Gemini API von Google infrage. Wichtig ist, nicht an einzelnen Modellnamen festzuhalten, sondern die jeweils verfügbaren Modelle nach Qualität, Kosten, Kontextfenster und API-Funktionalität auszuwählen. Gerade ältere Bezeichnungen wie GPT-4o oder Gemini 1.5 Pro sollten nicht ungeprüft als aktuelle Standardempfehlungen übernommen werden.
Bei der Bildgenerierung bieten sich beispielsweise die Bildmodelle von OpenAI und Google Gemini an.
Als Zielplattform eignet sich WordPress besonders gut. Die REST API ermöglicht den Zugriff auf Beiträge, Kategorien, Schlagwörter und Medien.
Schritt 1 – Structured Output: Warum saubere Daten wichtiger sind als schöne Prompts
Hier kommen wir zu einem der wichtigsten Punkte der gesamten Architektur. Viele Automatisierungsprojekte scheitern nicht an der KI, sondern an der Übergabe ihrer Ergebnisse. Ein Sprachmodell liefert beispielsweise einen hervorragenden Artikel, ergänzt aber ungefragt eine Erklärung vor dem eigentlichen JSON-Objekt. Oder es verändert Feldnamen, vergisst ein Pflichtfeld oder liefert die Tags als Fließtext statt als Array. Für einen Menschen ist das meistens kein Problem. Für einen automatisierten Workflow kann es das Ende der gesamten Verarbeitung bedeuten.
Die Lösung heißt Structured Output. Anstatt dem Modell lediglich mitzuteilen, dass es bitte JSON ausgeben soll, definieren wir ein verbindliches Datenmodell. Über JSON Schema lässt sich festlegen, welche Felder existieren, welche Datentypen erwartet werden und welche Werte zulässig sind. Moderne KI-APIs unterstützen diese strukturierte Ausgabe teilweise direkt. Bei OpenAI heißt die entsprechende Funktion Structured Outputs, bei Gemini gibt es ebenfalls eine JSON-Schema-basierte Ausgabe. Wichtig ist die Unterscheidung zwischen einfachem JSON-Modus und echter Schema-Konformität: Valides JSON bedeutet noch lange nicht, dass alle benötigten Felder korrekt vorhanden sind.
Für unseren Blog-Workflow definieren wir beispielsweise folgende Datenstruktur:
| Feld | Datentyp | Zweck |
| title | String | Hauptüberschrift |
| content_markdown | String | Vollständiger Artikel |
| seo_title | String | SEO-Titel, Richtwert max. 60 Zeichen |
| seo_description | String | Meta-Beschreibung, Richtwert max. 155 Zeichen |
| category | String/Enum | Kategorie aus festgelegter Themenliste |
| tags | Array | 3–5 relevante Schlagwörter |
| image_prompt | String | Beschreibung für das Beitragsbild |
Zusätzlich können Felder wie Primary Keyword, Secondary Keywords, Excerpt, Alt-Text, Quellen und interne Verlinkung aufgenommen werden. Je genauer das Schema definiert ist, desto weniger Interpretationsspielraum bleibt bei der Weiterverarbeitung. Die Zeichenbegrenzungen sollten allerdings zusätzlich durch eine eigene Validierungslogik kontrolliert werden, da nicht jede Schema-Implementierung sämtliche Einschränkungen unterstützt.
Ein weiterer Vorteil: Wir können bereits vor der eigentlichen WordPress-Übertragung prüfen, ob die Ausgabe vollständig ist. Fehlt beispielsweise der SEO-Titel, wird der Prozess nicht einfach fortgesetzt. Stattdessen startet eine gezielte Korrekturschleife. So verwandeln wir eine potenziell fehleranfällige KI-Ausgabe in einen kontrollierbaren Datenprozess.
Schritt 2 – Text- und SEO-Prompting: Der redaktionelle Qualitätsmotor
Ein strukturierter Output ist die technische Grundlage. Die eigentliche Qualität des Artikels entsteht allerdings durch die Kombination aus Kontext, Anweisungen und redaktionellen Leitplanken. Ein einfacher Prompt wie „Schreibe einen SEO-Artikel über Digitalisierung“ ist dafür schlicht zu wenig. Das Modell weiß weder, für wen es schreibt, noch welche fachliche Tiefe erwartet wird oder welche Positionierung die Website vertritt. Es produziert dann häufig genau das, was man von generischen KI-Texten kennt: grammatikalisch ordentlich, inhaltlich austauschbar und voller Aussagen, die sich überall lesen könnten.
Deshalb arbeiten wir mit einem mehrstufigen Prompt-Konzept.
Der System Prompt definiert die redaktionelle Identität. Hier hinterlegen wir die Persona, die Zielgruppe, den gewünschten Sprachstil, die fachliche Tiefe und die Formatierungsregeln. Für einen Digital-Business-Blog könnte das beispielsweise eine Mischung aus erfahrenem IT-Berater, Digitalstrategen und praxisorientiertem Technologie-Enthusiasten sein. Der Text soll fachlich fundiert, verständlich und meinungsstark sein, ohne in akademische Trockenheit abzurutschen. Auch konkrete Formatierungsregeln gehören hinein, beispielsweise eine nachvollziehbare H2/H3-Hierarchie, aussagekräftige Zwischenüberschriften und ausreichend ausführliche Erklärungen.
Der User Prompt liefert den konkreten Arbeitsauftrag. Dazu gehören das Hauptkeyword, ergänzende Suchbegriffe, die Zielgruppe, die Suchintention und gegebenenfalls eine vorgegebene Artikelstruktur. Besonders wichtig ist der Search-Intent-Abgleich. Sucht jemand nach „n8n WordPress automatisieren“, erwartet er wahrscheinlich eine praktische Anleitung und keine allgemeine Abhandlung über künstliche Intelligenz. Der Artikel muss deshalb die tatsächliche Informationsabsicht bedienen.
Bei der SEO-Integration sollten wir uns auf folgende Aspekte konzentrieren:
- Primär- und Sekundärkeywords: Das Hauptkeyword wird sinnvoll in Titel, Einleitung und relevanten Zwischenüberschriften platziert. Ergänzende Suchbegriffe erweitern den thematischen Kontext, ohne den Text künstlich aufzublähen. Entscheidend ist die natürliche Verwendung statt einer mechanischen Keyword-Dichte.
- Strukturierte Überschriften: H2- und H3-Überschriften bilden eine logisch nachvollziehbare Informationsarchitektur. Sie helfen Lesern, Suchmaschinen und KI-basierten Suchsystemen, die einzelnen Themenbereiche zu verstehen. Jede Überschrift sollte einen konkreten Informationswert transportieren.
- Semantische Relevanz: Neben dem Hauptkeyword berücksichtigen wir verwandte Begriffe, Fachterminologie, Entitäten und konkrete Anwendungsfälle. Ein Artikel über Workflow-Automatisierung sollte beispielsweise auch API, JSON, Webhooks, REST, Middleware und Datenvalidierung erklären.
- Suchintention und Mehrwert: Der Artikel beantwortet nicht nur die ursprüngliche Suchanfrage, sondern berücksichtigt auch typische Anschlussfragen. Wer einen Workflow aufbauen möchte, interessiert sich beispielsweise ebenfalls für Kosten, Sicherheit, Fehlerbehandlung und Wartung.
Eine interessante Erweiterung ist die Multi-Model-Strategie. Ein Modell erstellt zunächst die Gliederung und identifiziert inhaltliche Lücken. Ein zweites Modell übernimmt anschließend die eigentliche Textproduktion. Ein drittes kann den fertigen Beitrag kritisch prüfen. Das ist nicht automatisch besser, kann aber bei umfangreichen Fachartikeln eine sinnvolle Qualitätskontrolle ermöglichen. Wichtig ist, dass die Modelle nicht einfach gegenseitig ihre Aussagen bestätigen, sondern unterschiedliche Prüfaufgaben erhalten.
Schritt 3 – Automatisierte Visuals: Wenn der Artikel sein eigenes Titelbild bekommt
Ein guter Blogartikel braucht mehr als Text. Bilder schaffen Aufmerksamkeit, lockern längere Inhalte auf und können komplexe Themen visuell zugänglich machen. Gerade bei technischen Beiträgen ist ein passendes Beitragsbild ein wichtiger Bestandteil der Gesamtwirkung. Wer regelmäßig veröffentlicht, kennt allerdings den Aufwand: Bild recherchieren, Lizenz prüfen, herunterladen, bearbeiten, komprimieren, hochladen und anschließend noch einen passenden Alt-Text formulieren. Auch diese Arbeitsschritte lassen sich weitgehend automatisieren.
Unsere Content-Pipeline nutzt dafür den zuvor generierten image_prompt. Das Sprachmodell erhält den fertigen Artikel und entwickelt daraus eine eigenständige Bildbeschreibung. Dabei sollten Motiv, Perspektive, Bildkomposition, Lichtstimmung, Farbwelt und gewünschter Bildstil möglichst präzise definiert werden. Für einen Artikel über automatisierte Content-Produktion könnte das beispielsweise eine moderne digitale Redaktion mit mehreren miteinander verbundenen KI-Systemen, einem zentralen Workflow-Dashboard und einer professionellen technologischen Bildsprache sein. Eine No-Text-Policy verhindert, dass die Bildgenerierung ungewollte Schriftzüge, Logos oder schwer lesbare Textfragmente produziert. Das Ergebnis sollte zur visuellen Identität des Blogs passen.
Die eigentliche Bildgenerierung erfolgt anschließend über eine geeignete API, beispielsweise von OpenAI, Google oder anderen Anbietern. Der Workflow sendet den Prompt an den Dienst, verarbeitet die Antwort und wartet gegebenenfalls über einen asynchronen Status- beziehungsweise Abrufmechanismus auf das fertige Bild. Danach wird die Bilddatei heruntergeladen und für die Verwendung im CMS vorbereitet.
Das Postprocessing sollte mehrere Aufgaben umfassen:
- Formatkonvertierung: Das generierte Bild wird nach Möglichkeit in WebP umgewandelt. Das reduziert häufig die Dateigröße gegenüber klassischen PNG-Dateien, ohne dass sichtbare Qualitätsverluste entstehen müssen. Die optimale Kompression hängt allerdings vom Motiv und dem gewünschten Einsatz ab.
- Bildoptimierung: Abmessungen und Dateigröße werden an das verwendete WordPress-Theme angepasst. Ein überdimensioniertes Titelbild verursacht unnötigen Datentransfer und kann die Ladezeit negativ beeinflussen. Auch die Bildqualität sollte nach der Komprimierung kontrolliert werden.
- Alt-Text-Generierung: Ein Sprachmodell beschreibt den tatsächlichen Bildinhalt in einem verständlichen Satz. Der Alt-Text dient in erster Linie der Barrierefreiheit und unterstützt zusätzlich das Verständnis des Bildes durch Suchmaschinen. Reines Keyword-Stuffing ist hier fehl am Platz.
- Upload in die Mediathek: Über den WordPress-Endpunkt /wp/v2/media wird das Bild hochgeladen. Anschließend erhält der Workflow die Medien-ID zurück und kann diese für die spätere Beitragszuordnung verwenden.
Wichtig: Der Alt-Text muss das Bild tatsächlich beschreiben. Eine KI sollte deshalb nicht einfach den Artikeltitel in das Feld kopieren. Ebenso sollte das generierte Bild vor der Veröffentlichung auf Darstellungsfehler, ungewollte Elemente und mögliche Markenrechtsverletzungen geprüft werden.
Schritt 4 – Dynamische Kategorien und Tags: Ordnung statt digitalem Wildwuchs
Ein Blog wächst mit jedem veröffentlichten Artikel. Ohne konsequente Kategorisierung entsteht allerdings schnell ein unübersichtliches Sammelsurium aus Schlagwörtern und Themenbereichen. Genau deshalb gehört die Taxonomie-Verwaltung in unseren automatisierten Workflow. Die KI soll nicht einfach für jeden Artikel neue Kategorien erfinden, sondern sich innerhalb einer definierten redaktionellen Struktur bewegen.
Der erste Schritt ist der Abgleich mit den bestehenden WordPress-Kategorien. Über den REST-Endpunkt /wp/v2/categories liest n8n die verfügbaren Kategorien einschließlich ihrer IDs aus. Das Sprachmodell schlägt anhand des Artikelinhalts eine passende Kategorie vor. Die Automatisierung vergleicht anschließend den Vorschlag mit dem vorhandenen Bestand. Dabei sollte möglichst mit festen Kategorie-IDs oder eindeutigen Slugs gearbeitet werden. So vermeiden wir, dass aus „IT-Sicherheit“, „IT Sicherheit“ und „Informationssicherheit“ versehentlich drei konkurrierende Kategorien werden.
Bei den Tags gehen wir etwas flexibler vor. Hier kann das Modell relevante Entitäten aus dem Artikel extrahieren. Dazu gehören beispielsweise Personen, Technologien, Softwareprodukte, Methoden und Fachbegriffe. Für einen Beitrag über Content-Automatisierung wären n8n, WordPress, REST API, Structured Output und Workflow-Automatisierung mögliche Schlagwörter. Allerdings sollte nicht jeder Begriff automatisch ein Tag werden. Eine zu große Anzahl wenig aussagekräftiger Tags verwässert die thematische Struktur und erzeugt unnötige Pflegearbeit.
Die technische Zuordnung funktioniert folgendermaßen:
- Bestehende Tags über /wp/v2/tags abrufen.
- Generierte Schlagwörter mit vorhandenen Namen und Slugs vergleichen.
- Bereits vorhandene Tags über ihre IDs übernehmen.
- Fehlende Tags über die REST API neu anlegen.
- Alle ermittelten IDs dem späteren WordPress-Beitrag zuweisen.
Gerade bei der Neuanlage empfiehlt sich eine zusätzliche Normalisierung. Groß- und Kleinschreibung, Sonderzeichen und unterschiedliche Schreibweisen sollten berücksichtigt werden. Außerdem ist eine Obergrenze sinnvoll, damit die KI nicht plötzlich 25 neue Tags für einen einzigen Beitrag erzeugt. Die Entscheidung über neue Kategorien sollte grundsätzlich restriktiver ausfallen als bei Schlagwörtern.
Schritt 5 – Der Veröffentlichungs-Workflow: Alles zusammenführen
Jetzt wird es spannend. Wir haben einen Artikel, SEO-Metadaten, ein Beitragsbild und die passenden Taxonomien. Nun müssen alle Bestandteile in einem einzigen WordPress-Beitrag zusammengeführt werden. Hier übernimmt die REST API die zentrale Rolle. Über den Endpunkt /wp-json/wp/v2/posts können wir einen neuen Beitrag erstellen und die zuvor erzeugten Informationen übergeben.
Der Request enthält beispielsweise den Titel, den Artikelinhalt, den Auszug, die Kategorie-IDs, die Tag-IDs und die Medien-ID des Beitragsbildes. Auch der gewünschte Veröffentlichungsstatus wird festgelegt. Für unseren Workflow verwenden wir zunächst grundsätzlich draft. Dadurch landet der Artikel als Entwurf im CMS, ohne automatisch öffentlich sichtbar zu werden. WordPress unterstützt darüber hinaus weitere Status wie pending, private, future und publish.
Eine beispielhafte Payload könnte so aussehen:
{
"title": "Blog automatisieren: Der komplette Workflow",
"content": "

Einleitung

...

",
"excerpt": "So automatisierst du deine Content-Produktion.",
"status": "draft",
"categories": [12],
"tags": [34, 56, 78],
"featured_media": 145
}
Die SEO-Metadaten benötigen allerdings eine gesonderte Betrachtung. WordPress besitzt zwar ein allgemeines Meta-Feld, aber nicht jedes SEO-Plugin erlaubt automatisch das Schreiben seiner Metadaten über die Standard-REST-API. Bei Yoast SEO, Rank Math oder SEOPress muss geprüft werden, welche Felder registriert und für die REST API freigegeben sind. Gegebenenfalls ist eine eigene Plugin-Erweiterung oder ein zusätzlicher REST-Endpunkt erforderlich. Die bloße Übergabe von seo_title und seo_description im Request reicht nicht aus.
Auch die Authentifizierung darf nicht unterschätzt werden. WordPress Application Passwords ermöglichen eine separate, widerrufbare Authentifizierung für Integrationen. Sie sind deutlich sinnvoller, als das reguläre Administratorkennwort in einem Workflow zu hinterlegen. Idealerweise wird ein eigener WordPress-Benutzer mit möglichst eingeschränkten Berechtigungen verwendet. Zugangsdaten gehören ausschließlich in einen geschützten Credential-Speicher und niemals in öffentlich zugängliche Workflow-Definitionen.
Und jetzt kommt der wichtigste Punkt: Human-in-the-Loop.
Ein vollständig automatisierter Veröffentlichungsprozess klingt zunächst verlockend. Schließlich könnte der Workflow jeden Morgen fünf neue Beiträge produzieren und direkt veröffentlichen. Fachlich halte ich das allerdings für einen gefährlichen Ansatz, sobald die Inhalte einen gewissen Qualitätsanspruch erfüllen sollen.
Die menschliche Kontrollschleife sollte mindestens folgende Punkte umfassen:
- Faktenprüfung: Stimmen Zahlen, technische Aussagen, Produktnamen und Quellen? Besonders bei schnelllebigen Technologiethemen können KI-Modelle veraltete Informationen liefern. Unbelegte Aussagen müssen korrigiert oder entfernt werden.
- Redaktionelle Prüfung: Ist der Text verständlich, vollständig und frei von Wiederholungen? Entspricht er der gewünschten Tonalität? Ist eine eigenständige fachliche Perspektive erkennbar?
- SEO-Qualitätskontrolle: Sind Suchintention, Überschriftenstruktur, Meta-Daten, interne Verlinkungen und Bildinformationen sinnvoll umgesetzt? Ein grünes SEO-Plugin-Symbol ist noch kein Qualitätsnachweis.
- Rechtliche Prüfung: Sind Bildrechte, Quellenangaben, Datenschutz und gegebenenfalls Kennzeichnungspflichten berücksichtigt? Gerade bei automatisiert übernommenen Informationen ist besondere Sorgfalt erforderlich.
Erst nach dieser Freigabe erfolgt die Veröffentlichung. Die Automatisierung übernimmt damit die Fleißarbeit, während die redaktionelle Verantwortung dort bleibt, wo sie hingehört: beim Menschen.
Fazit: Automatisierung ist kein Ersatz für Qualität, sondern ihr Skalierungshebel
Ein vollautomatisierter Blog-Workflow ist längst keine Zukunftsmusik mehr. Die Kombination aus n8n, modernen Sprachmodellen, Bildgenerierung und einer CMS-Schnittstelle ermöglicht eine Content-Produktion, die vor wenigen Jahren noch einen erheblichen Entwicklungsaufwand erfordert hätte. Heute lassen sich solche Systeme mit überschaubarem technischen Aufwand aufbauen und schrittweise erweitern. Besonders für kleine Unternehmen, spezialisierte Fachblogs und Einzelunternehmer ergeben sich dadurch interessante Möglichkeiten. Wer regelmäßig hochwertige Inhalte veröffentlichen möchte, kann einen erheblichen Teil der wiederkehrenden Produktionsarbeit automatisieren.
Allerdings sollten wir nicht den Fehler machen, die Anzahl produzierter Artikel mit dem tatsächlichen Erfolg gleichzusetzen. Hundert mittelmäßige KI-Beiträge sind keine bessere Content-Strategie als zehn wirklich gute Fachartikel. Suchmaschinen und KI-basierte Antwortsysteme benötigen nachvollziehbare, hilfreiche und vertrauenswürdige Informationen. Eine automatisierte Pipeline muss deshalb nicht nur Texte produzieren, sondern Qualität systematisch absichern. Dazu gehören Quellenprüfung, fachliche Plausibilität, redaktionelle Kontrolle und eine konsequente Überwachung der Ergebnisse.
Besonders interessant wird das Ganze, wenn wir über die reine Artikelerstellung hinausdenken. Einmal aufgebaute Workflows lassen sich relativ einfach um weitere Prozesse ergänzen:
- Automatisches Content-Monitoring: Die Pipeline kann regelmäßig Leistungsdaten auswerten. Dazu gehören Impressionen, Klicks, Rankings und organischer Traffic. Werden Beiträge schlechter gefunden, kann ein Aktualisierungsprozess ausgelöst werden. Wichtig ist dabei, nicht jede Ranking-Schwankung automatisch mit einer Textänderung zu beantworten.
- Automatische Aktualisierung bestehender Artikel: Veraltete Produktinformationen, geänderte API-Schnittstellen oder neue gesetzliche Anforderungen können erkannt werden. Ein KI-Modell erstellt daraufhin einen Aktualisierungsvorschlag. Die Änderungen werden zunächst als Überarbeitung oder neuer Entwurf bereitgestellt und anschließend redaktionell geprüft.
- Multi-Channel-Repurposing: Aus einem ausführlichen Blogartikel entstehen automatisch LinkedIn-Beiträge, Social-Media-Posts, Newsletter und kurze Zusammenfassungen. Dabei sollte jeder Kanal eine eigene Ansprache und Formatierung erhalten. Einfach denselben Text überall zu veröffentlichen, verschenkt Potenzial.
- Performance-basierte Themenplanung: Die Ergebnisse veröffentlichter Beiträge fließen zurück in die redaktionelle Planung. Erfolgreiche Themen können vertieft, verwandte Suchanfragen identifiziert und neue Artikelideen vorgeschlagen werden.
Auch die Wirtschaftlichkeit sollte regelmäßig überprüft werden. API-Kosten für Text- und Bildgenerierung, Hosting, Workflow-Ausführung und gegebenenfalls zusätzliche Recherchewerkzeuge müssen der eingesparten Arbeitszeit gegenübergestellt werden. Dabei zählt nicht nur die reine Schreibzeit. Auch Formatierung, Bildbearbeitung, Upload, Verschlagwortung und administrative Tätigkeiten verursachen Aufwand. Eine gut konzipierte Automatisierung reduziert diese wiederkehrenden Tätigkeiten erheblich.
Mein persönliches Fazit: Der eigentliche Wert eines automatisierten Blog-Workflows liegt nicht darin, möglichst viele Artikel möglichst schnell zu produzieren. Er liegt darin, einen reproduzierbaren Prozess zu schaffen, der aus einer guten Idee zuverlässig einen qualitativ hochwertigen redaktionellen Entwurf macht. Wer seine Datenstrukturen, Prompts und Kontrollmechanismen sauber entwickelt, schafft sich eine Content-Infrastruktur, die mit den eigenen Anforderungen wachsen kann.
Und genau das ist der Unterschied zwischen ein bisschen KI-Spielerei und professioneller Prozessautomatisierung. Nicht die KI macht den Workflow intelligent. Es ist die Architektur, mit der wir sie einsetzen.
Leserfrage:
Wie weit würdest du bei der Automatisierung deiner Content-Produktion gehen? Würdest du einen KI-generierten Artikel nach einer Qualitätskontrolle automatisch veröffentlichen lassen oder bleibt der letzte Klick grundsätzlich menschliche Aufgabe?